蛋白不是一个名字:修饰组学和 Proteoform 为什么重要
系列第六篇
前几篇我们讲的是:蛋白能不能测到、能不能量准、能不能测很多样本、能不能测小样本。
这一篇进入更本质的问题:同一个蛋白名下面,可能藏着很多不同的功能状态。
本文导读
在很多蛋白质组学文章里,我们习惯说:某个蛋白上调了,某个蛋白下调了,某条通路被激活了,某个标志物和疾病相关。
但如果继续追问一步,问题就会变得复杂:
- 这个蛋白真的“激活”了吗?
- 它有没有被磷酸化?
- 有没有被泛素化、乙酰化或糖基化?
- 它处在细胞核、线粒体、膜表面,还是分泌到细胞外?
- 它是哪个剪接异构体?
- 它有没有携带突变?
- 它是游离状态,还是和其他蛋白组成复合物?
也就是说,蛋白不是一个名字。
同一个基因名或同一个蛋白名,可能对应一组状态完全不同的分子实体。一个蛋白的丰度没有明显变化,不代表它没有功能变化;反过来,一个蛋白丰度升高,也不一定说明它真正处于活性状态。
这就是第六篇要讲的主题:修饰组学和 proteoform。
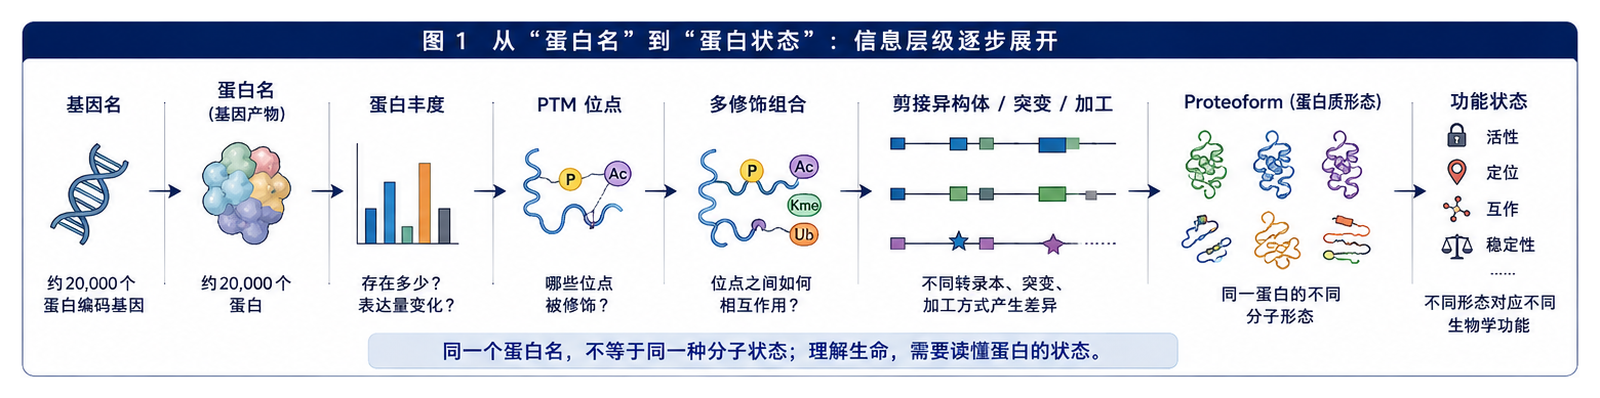
图 1|从“蛋白名”到“蛋白状态”
同一个蛋白名,不等于同一种分子状态。理解生命,需要读懂蛋白的状态。
一、为什么“蛋白丰度”还不够?
蛋白质组学最基础的任务,是告诉我们一个样本里有哪些蛋白,以及它们的丰度如何变化。
这当然重要。
如果某个酶表达量升高,某个受体减少,某个炎症因子增加,这些都可能提示疾病、药物或细胞状态的改变。
但生命活动并不只靠蛋白“多少”来调控。很多时候,真正决定功能的是蛋白的状态。
比如,一个激酶是否活跃,往往不只取决于激酶蛋白的总量,而取决于关键位点是否被磷酸化。一个蛋白是否被降解,可能取决于它是否被特定类型的泛素链标记。一个膜蛋白如何与外界环境交流,可能取决于它的糖基化结构。一个转录因子是否进入细胞核、是否结合 DNA,也可能受到乙酰化、甲基化、磷酸化等多种修饰共同影响。
PTMD 2.0 数据库的更新很好地说明了这一点:该数据库收录了 93 类 PTM 与 2083 种疾病相关的 342,624 条 PTM–疾病关联,显示异常修饰状态已经成为理解疾病机制的重要信息层。[1]
所以,如果说常规蛋白质组学回答的是:
这个蛋白有多少?
那么修饰组学进一步追问:
这个蛋白正在以什么方式工作?
二、什么是 PTM?蛋白质的“功能开关”和“状态标签”
PTM,全称 post-translational modification,中文通常叫翻译后修饰。
简单说,就是蛋白质翻译完成之后,某些氨基酸残基被加上、去掉或改变了一些化学基团。UniProt 的 PTM 列表和 PTMD 2.0 文献都显示,目前已发现的 PTM 类型已经超过数百种,其中磷酸化和泛素化是研究最多的类型之一。[1]
常见 PTM 可以这样理解:
| 修饰类型 | 可以怎么理解 | 典型生物学意义 |
|---|---|---|
| 磷酸化 | 给蛋白加一个“开关” | 信号转导、激酶活性、细胞周期 |
| 泛素化 | 给蛋白贴一个“命运标签” | 蛋白降解、DNA 修复、免疫调控 |
| 乙酰化 | 改变蛋白电荷和互作 | 染色质调控、代谢酶调控 |
| 甲基化 | 精细调节蛋白识别 | 组蛋白调控、转录调控 |
| 糖基化 | 给蛋白加上“糖链外衣” | 分泌、膜蛋白功能、免疫识别 |
| SUMOylation / NEDDylation | 泛素样修饰 | 蛋白定位、稳定性、应激响应 |
| 脂质化 | 加上疏水基团 | 膜定位、信号复合物组装 |
PTM 的重要性在于,它让蛋白质组从“静态清单”变成“动态调控系统”。
一个蛋白可以同时携带多个修饰。不同修饰之间还可能互相影响:一个位点的磷酸化可能促进泛素化,某种乙酰化可能阻止另一个位点被修饰,糖基化可能影响蛋白折叠和分泌。这种修饰之间的相互作用,构成了蛋白质层面的复杂调控网络。
这也是为什么修饰组学常常比常规蛋白质组学更接近“功能状态”。
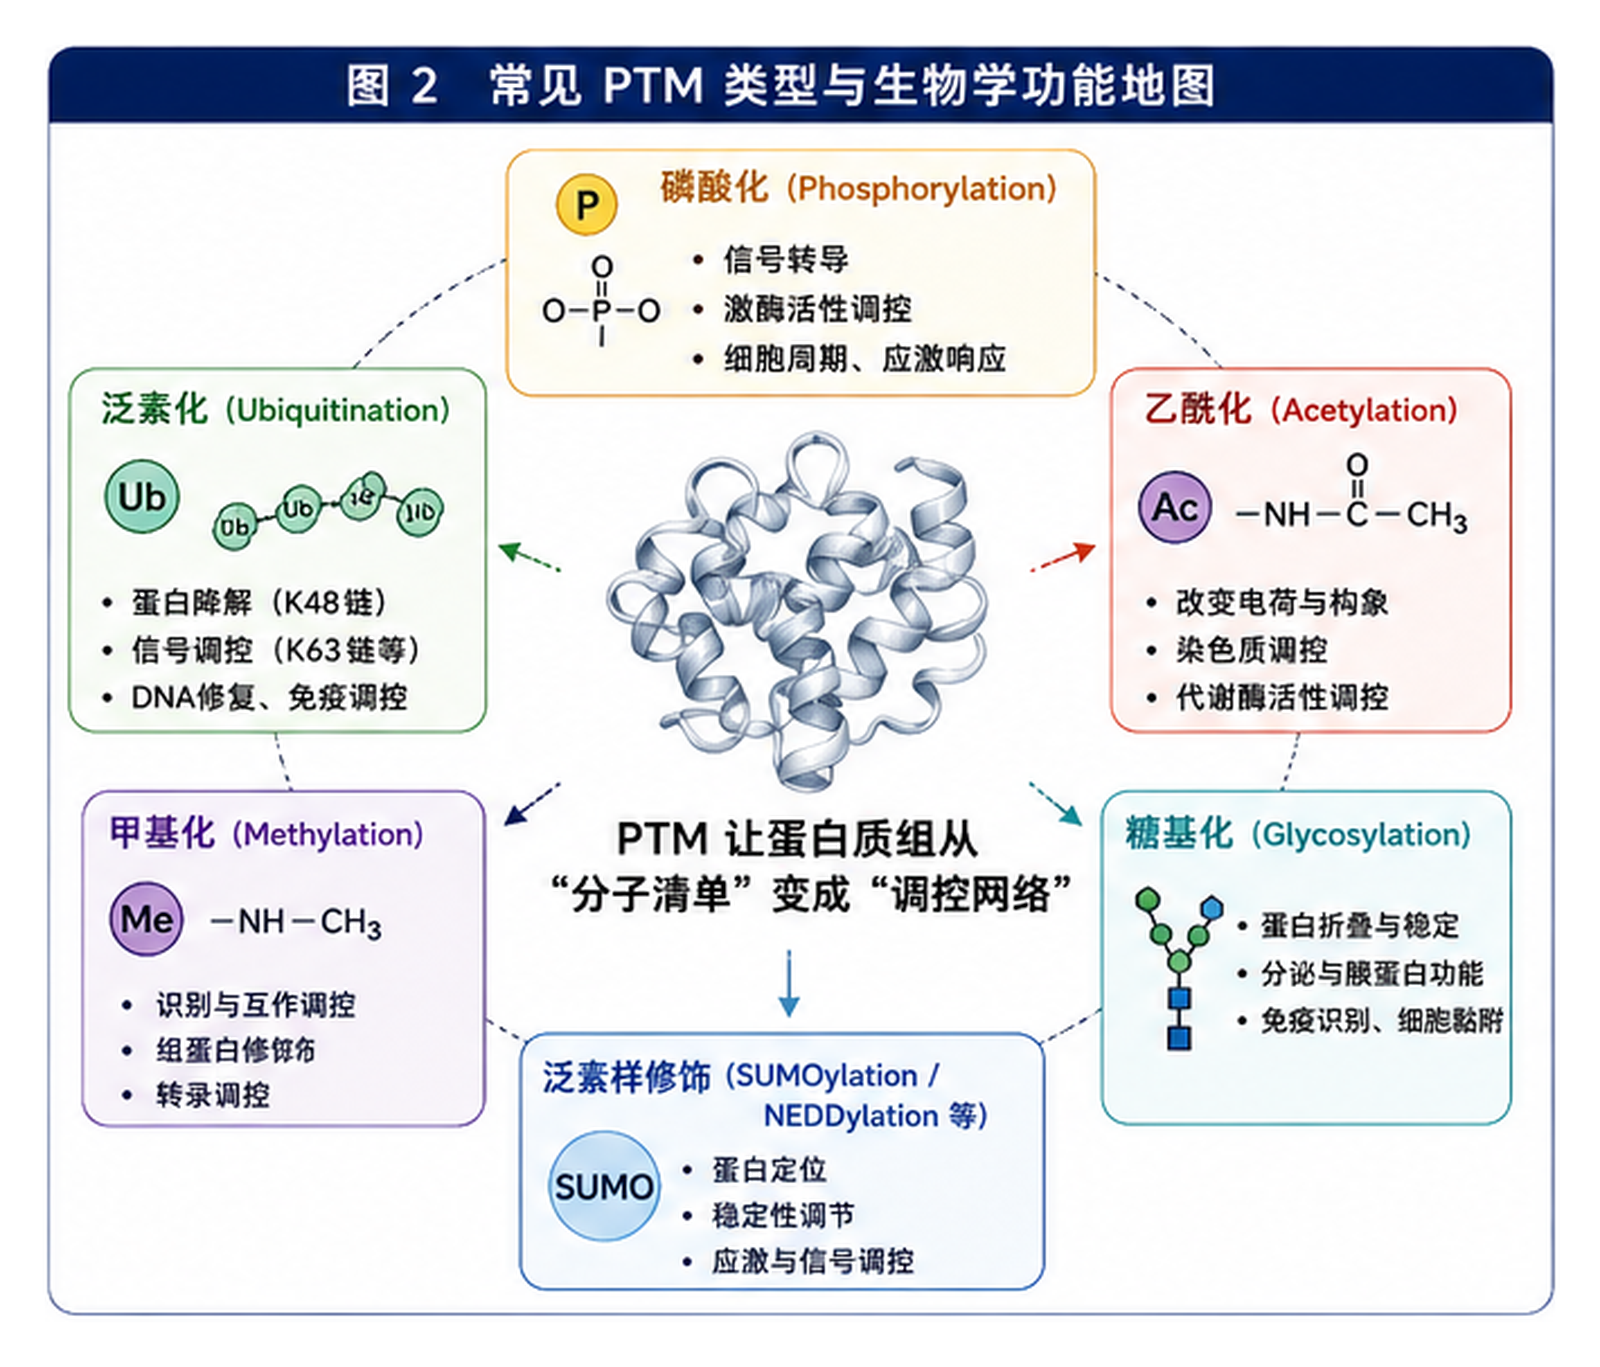
图 2|常见 PTM 与生物学功能地图
PTM 让蛋白质组从“分子清单”变成“调控网络”。
三、修饰组学为什么更难?
修饰组学很有价值,但也更难。
常规蛋白质组学已经很复杂,而 PTM 分析还要多解决几个问题。
1. 修饰肽段通常丰度更低
一个蛋白可能有很多拷贝,但其中只有一小部分在某个位点被修饰。整体蛋白丰度很高,不代表修饰肽段容易被测到。
2. 修饰位点需要定位
测到一个修饰肽段还不够,还要判断修饰到底发生在哪个氨基酸残基上。比如一个肽段里有多个丝氨酸和苏氨酸,磷酸基团到底在第几个位置,必须通过碎片离子证据来定位。
3. 不同修饰需要不同富集策略
磷酸化常用 IMAC、TiO₂ 等富集方法;泛素化常用 K-ε-GG remnant 抗体富集;乙酰化常用抗乙酰赖氨酸抗体;糖基化则涉及 HILIC、lectin、亲水富集、糖肽完整解析等多种策略。早期 PTM proteomics 综述已经指出,修饰特异性富集与先进 MS/MS 和计算分析结合,是全局 PTM 分析的关键基础。[2]
4. 数据分析更复杂
PTM 会增加搜索空间。一个肽段如果允许多个可能修饰,候选组合会迅速增加,FDR 控制、位点定位、定量一致性都会变难。糖基化尤其复杂,因为完整糖肽需要同时识别肽段序列、糖链结构和修饰位点;Nature Reviews Methods Primers 的糖蛋白组学综述也强调,完整糖肽分析已经成为糖蛋白组学的重要方向,但样本制备、碎裂方式和生信解析仍然是关键挑战。[5]
所以,修饰组学不是在常规蛋白质组学后面“多加一个搜索参数”这么简单。
它需要专门的样本制备、专门的质谱方法、专门的数据分析和专门的生物学解释。
四、磷酸化蛋白质组学:最接近“通路活性”的一层读数
所有 PTM 中,磷酸化是最经典、也是应用最广的一类。
磷酸化之所以重要,是因为它直接参与细胞信号转导。激酶和磷酸酶共同决定了很多蛋白的开关状态。细胞增殖、凋亡、炎症、代谢、迁移、DNA 修复和药物响应,都可能通过磷酸化网络调控。
如果常规蛋白质组学告诉我们“某条通路的蛋白是否存在”,那么磷酸化组学更接近回答:
这条通路是否真的被激活?
这在癌症和药物研究中尤其重要。很多抗癌药本质上就是激酶抑制剂;药物是否真正抑制了目标通路,常常需要看下游磷酸化位点的变化,而不仅是看激酶蛋白本身有没有表达。
过去十年,磷酸化蛋白质组学从“能测很多位点”逐渐走向“快速、深度、定量”。2024 年 Nature Communications 的 Orbitrap Astral 磷酸化蛋白组研究展示了这一趋势:研究者使用 Orbitrap Astral 与 DIA,在半小时数据采集内绘制约 30,000 个独特人类磷酸化位点,并在 12 小时测量中检测到 81,120 个小鼠多组织独特磷酸化位点。[3]
这类进展说明,修饰组学正在跟上前几篇讲过的技术路线:更快的仪器、更强的 DIA、更好的软件,也开始把 PTM 分析推向高通量和大规模比较。
不过,磷酸化组学也有一个现实问题:测到磷酸化位点,并不等于立刻知道它的功能。2025 年一项关于癌症 “dark phosphoproteome” 的研究指出,在大规模 CPTAC pan-cancer 磷酸化蛋白组数据中,虽然覆盖了大量磷酸化位点,但已知上游激酶或明确功能注释的位点仍然只占很小比例。[10]
这提示我们:磷酸化组学已经能产生大量数据,但真正的挑战正在变成——如何把位点变化解释成激酶活性、通路状态和疾病机制。
五、泛素化蛋白质组学:蛋白命运的调度系统
如果说磷酸化更像“开关”,泛素化则更像“标签”。
一个蛋白被泛素化之后,可能被送去蛋白酶体降解,也可能改变定位、参与 DNA 修复、调控炎症和免疫信号。泛素化并不是简单的“降解标签”,因为泛素本身可以形成不同链型,例如 K48、K63、M1 等,不同链型代表不同功能语境。
泛素化组学的关键技术之一,是识别被泛素修饰的赖氨酸位点。蛋白经过胰蛋白酶消化后,被泛素化的赖氨酸残基上会留下一个 diglycine remnant,也常写作 K-ε-GG。研究者可以使用特异性抗体富集这类肽段,再用 LC-MS/MS 做全局分析。
Nature Reviews Methods Primers 关于 ubiquitin-like modification proteomics 的综述总结了多种泛素及泛素样修饰的蛋白质组策略,包括 remnant profiling、亲和富集、UBL traps 和 ubiquitin clipping 等路线,说明泛素化分析已经形成了一套相对独立的方法生态。[4]
泛素化组学对药物研发尤其重要。
很多新药方向都与蛋白降解有关,比如 PROTAC、分子胶、E3 连接酶调控、去泛素化酶抑制剂等。这些药物的核心问题不是“蛋白表达量有没有变”,而是“目标蛋白是否被泛素化、是否被降解、哪些非目标蛋白也被影响”。
所以,泛素化组学的价值在于,它把蛋白质组学从“表达变化”推进到“蛋白命运变化”。
六、糖蛋白组学:最复杂,也最接近细胞外交流的一层
糖基化是另一类非常重要、也非常复杂的 PTM。
很多分泌蛋白、膜蛋白和细胞表面受体都带有糖链。糖基化参与蛋白折叠、稳定性、分泌、免疫识别、细胞黏附和病原体感染过程。抗体药物的糖基化状态,也会影响药物功能和安全性。
糖蛋白组学难在几个地方。
第一,糖链不是像 DNA 或蛋白序列那样由模板直接决定,而是由一系列糖基转移酶、糖苷酶、细胞器环境和底物可及性共同影响。
第二,同一个位点可能有多种糖型。
第三,同一个糖型可能有结构异构体。
第四,完整糖肽的 MS/MS 解析需要同时解释肽段骨架和糖链碎片。
Nature Reviews Methods Primers 的糖蛋白组学综述指出,完整糖肽分析的目标,是在系统层面同时理解肽段序列、糖链结构和修饰位点;这也是当前糖蛋白组学的重要社区方向。[5]
过去几年,糖蛋白组学也开始受益于 AI 和 DIA。2024 年 DeepGlyco 工作使用深度学习预测完整糖肽碎片谱,并指出预测谱图库可以补充 DIA 糖蛋白组学中的谱图库完整性。[6] 另一项 2024 年 Nature Communications 工作则通过建模碎裂、洗脱和 glycome connectivity 来扩展 N-糖肽鉴定,反映出糖蛋白组学正在从“能不能解析”走向“如何规模化、自动化、可靠解析”。[7]
糖蛋白组学适合在公众号里写得稍微形象一点:
蛋白质像一栋房子,糖链像房子外面的门牌、装饰和通行证。外界细胞、免疫系统、病原体和药物,很多时候不是只看蛋白主体,也会读懂这些糖链信息。
七、从单一修饰到“多修饰网络”
现实中的蛋白往往不是只带一种修饰。
一个转录因子可能同时被磷酸化、乙酰化、泛素化。
一个线粒体酶可能同时受到磷酸化、乙酰化、琥珀酰化影响。
一个受体可能既有糖基化,也有磷酸化和泛素化。
一个组蛋白尾部可能携带多个甲基化、乙酰化和磷酸化位点。
这意味着修饰组学最终不是要得到一堆孤立的位点,而是要理解修饰之间的组合关系。
这也是 proteoform 概念开始变得重要的原因。
如果只看一个磷酸化位点,我们是在看一个局部事件。
如果能看到同一个蛋白分子上多个修饰、剪接形式、突变和加工事件的组合,我们才真正接近这个蛋白在细胞中的实际形态。
这就进入了下一层:proteoform。
八、什么是 Proteoform?同一个蛋白名下的不同“真实形态”
Proteoform 通常译作蛋白质形态或蛋白形式。
一个基因可以产生多个蛋白产物。不同转录本、剪接异构体、遗传变异、蛋白加工、PTM 组合,都可能产生不同 proteoform。
Nature Reviews Methods Primers 的 top-down proteomics 综述指出,proteoform 来自 PTM、遗传多态性和 RNA 剪接变体等多种来源,并在生物学中扮演关键角色。[8] 2024 年 Nature Methods 关于 top-down 样本制备的分析也强调,proteoforms 是同一蛋白的不同分子形式,包括遗传变异、剪接变体以及共翻译和翻译后修饰;不同 proteoform 可能具有显著不同的生物学功能。[9]
这句话对公众号读者很重要:
基因名相同,不等于蛋白状态相同。
蛋白名相同,也不等于分子功能相同。
比如:
- 一个蛋白没有磷酸化时是低活性状态,磷酸化后变成高活性状态。
- 一个蛋白有两个剪接异构体,一个定位在细胞核,一个定位在线粒体。
- 一个蛋白带有不同糖链,可能影响免疫识别。
- 一个蛋白同时携带多个修饰,可能改变互作伙伴。
- 一个蛋白发生突变后,又叠加某种修饰,可能形成疾病相关 proteoform。
所以,proteoform 是一个比“蛋白”更贴近真实分子状态的概念。
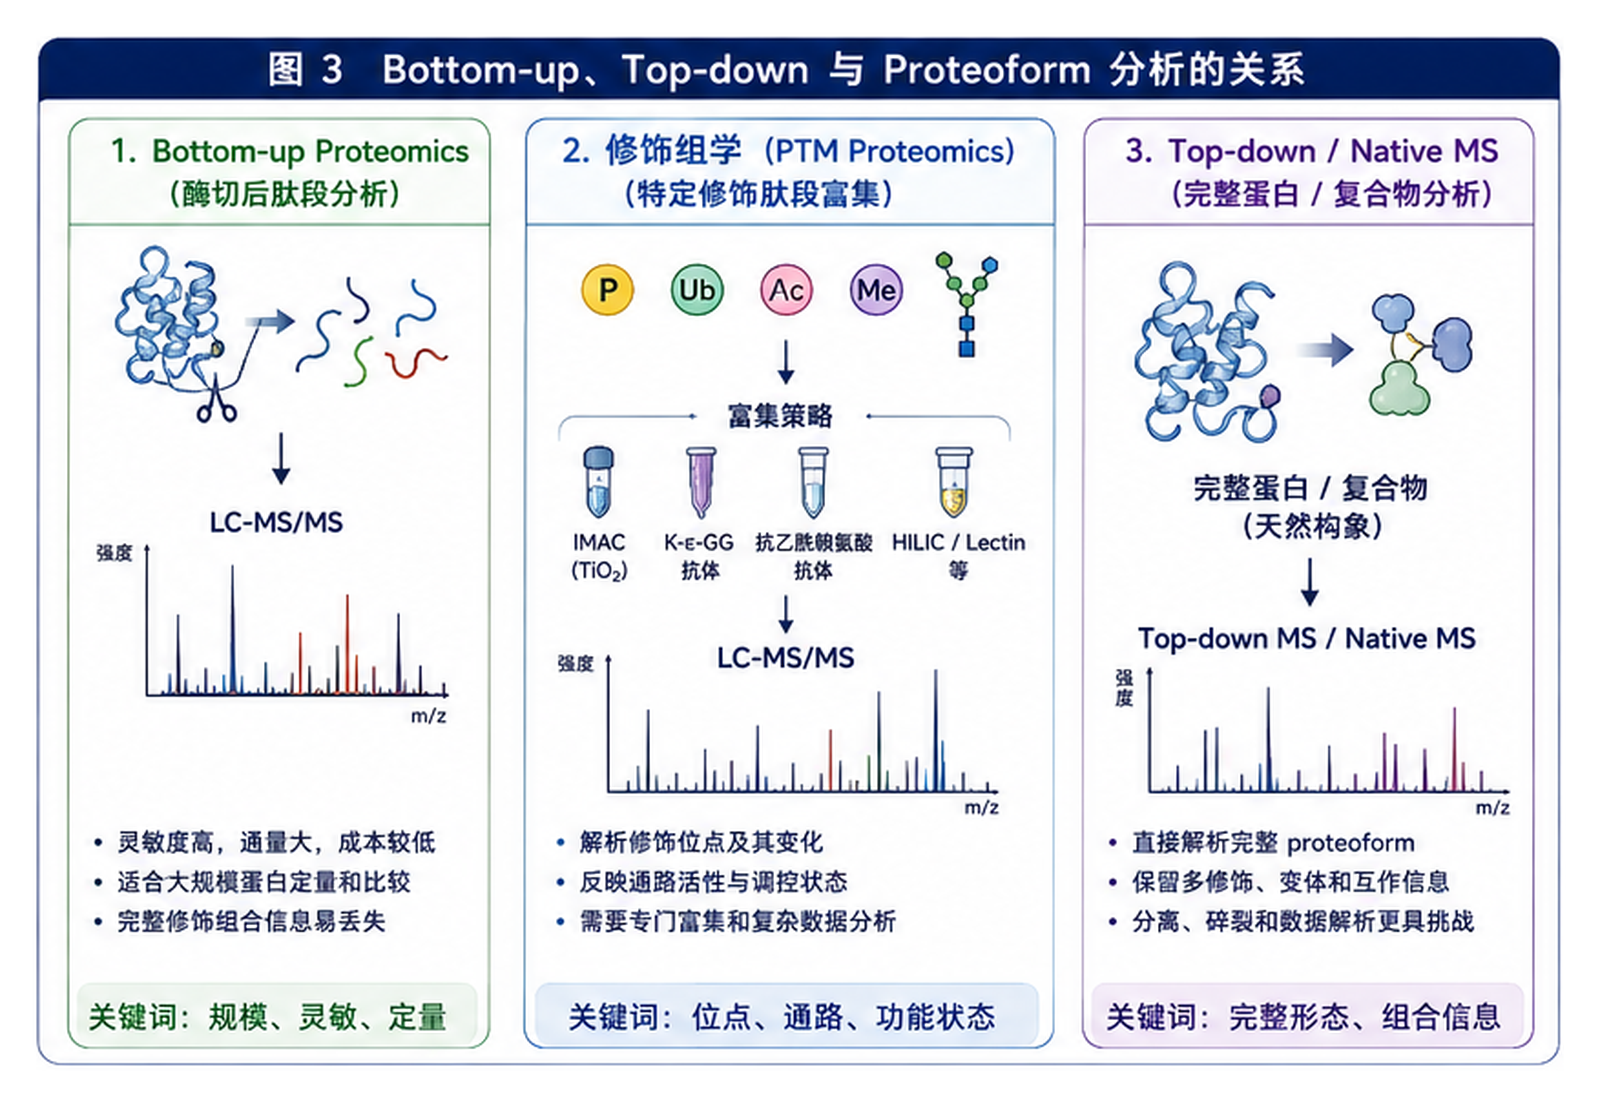
图 3|Bottom-up、Top-down 与 Proteoform 的关系
Bottom-up 看规模,Top-down 看完整形态;两者共同逼近真实蛋白质组。
九、Bottom-up 与 Top-down:两种看蛋白状态的方式
常规蛋白质组学大多采用 bottom-up proteomics。
也就是先把蛋白酶切成肽段,再测肽段,最后推断蛋白。这种方法灵敏、成熟、通量高,适合大规模蛋白质组学,也是前几篇一直在讲的主流路线。
但 bottom-up 有一个限制:蛋白被切碎之后,很多“组合信息”会丢失。
比如,一个蛋白上有两个修饰位点,bottom-up 可能分别测到两个肽段,但未必知道这两个修饰是否出现在同一个蛋白分子上。更复杂的情况是,一个蛋白有不同剪接异构体、多个 PTM 和突变,如果只看肽段,最终可能难以还原完整 proteoform。
Top-down proteomics 采用另一种思路:尽量直接分析完整蛋白或较大蛋白片段。
这样做的优势是,可以更直接地观察完整 proteoform,包括多个修饰、变体和加工事件的组合。Nature Reviews Methods Primers 2024 年 top-down proteomics 综述也把 intact proteoform 的分析作为 top-down 的核心价值之一。[8]
但 top-down 也很难。
完整蛋白比肽段更难分离、更难离子化、更难碎裂、更难解析。蛋白越大,谱图越复杂,数据分析越困难。2024 年 Nature Methods 的社区研究聚焦 native top-down MS,说明完整 proteoform 及其复合物分析已经成为社区共同推动的前沿方向,但也需要跨平台、跨实验室的标准化和 benchmark。[11]
可以这样概括:
| 路线 | 看什么 | 优势 | 局限 |
|---|---|---|---|
| Bottom-up | 酶切后的肽段 | 灵敏、高通量、适合大规模定量 | 完整 proteoform 组合信息容易丢失 |
| Middle-down | 较大片段 | 保留部分组合信息 | 方法和分析复杂度较高 |
| Top-down | 完整蛋白 / proteoform | 更直接解析完整蛋白形态 | 分离、碎裂、鉴定和定量难度高 |
| Native MS / native top-down | 近天然状态蛋白和复合物 | 可联系修饰与复合物状态 | 对仪器、样本和算法要求很高 |
因此,未来不是 top-down 取代 bottom-up,而是两者互补。
Bottom-up 负责规模和灵敏度,top-down 负责完整形态和组合信息。
十、Proteoform 为什么会成为下一代蛋白质组学的关键词?
Human Proteoform Project 提出,要推动技术发展并建立高质量的人类 proteoform 图谱;该倡议认为,下一代人类蛋白质组学应围绕约 20,000 个 proteoform families 展开,也就是每个蛋白编码基因对应一个 proteoform 家族。[12]
这个想法很有前瞻性。
过去,我们说“人类蛋白质组”,常常指 2 万个左右蛋白编码基因的蛋白产物。但如果考虑剪接、突变、加工和 PTM 组合,真实 proteoform 的数量会远远超过基因数量。
这也解释了为什么“测到蛋白”只是第一步。
如果只知道某个蛋白存在,我们还不知道它是哪一种形态。
如果只知道蛋白丰度变化,我们还不知道它的活性状态。
如果只知道一个修饰位点变化,我们还不知道它是否与其他修饰共存。
如果不知道 proteoform,我们可能会把功能完全不同的分子状态混在一起讨论。
2025 年 Nature Methods 的 native top-down 研究进一步说明了这个趋势:该研究提出 precisION 软件,用于在 intact protein complexes 中检测、定位和定量未表征或低丰度的 “hidden modifications”,目标是在天然结构背景中保留修饰与分子互作之间的联系。[13]
这代表了一个重要方向:未来蛋白质组学不仅要知道“蛋白叫什么”,还要知道“这个蛋白以什么完整形态存在,并且和谁一起工作”。
十一、修饰组学和 Proteoform 如何服务疾病与药物研究?
这一篇不能只讲技术,还要讲为什么这些技术重要。
1. 疾病机制:从表达异常到调控异常
很多疾病并不是某个蛋白简单上调或下调,而是调控状态异常。
癌症中,激酶通路异常激活;神经退行性疾病中,蛋白聚集、截断和异常修饰可能参与病理过程;免疫疾病中,受体信号、泛素化和糖基化都可能影响细胞状态。PTMD 2.0 收录的大规模 PTM–疾病关联,也说明 PTM 已经成为疾病机制研究的重要知识层。[1]
2. 药物发现:药物最终改变的是蛋白状态
药物可以改变蛋白表达,但更常见的是改变蛋白活性、修饰、互作或降解。
- 激酶抑制剂需要看磷酸化变化。
- 蛋白降解药物需要看泛素化和靶蛋白降解。
- 表观遗传药物需要看组蛋白修饰。
- 抗体药物需要看糖基化和结构状态。
- 靶点验证需要看目标 proteoform 是否真的被影响。
这就是为什么修饰组学和 proteoform 分析会越来越靠近药物研发。
3. 生物标志物:不只是“蛋白水平”,也可能是“修饰状态”
一个疾病相关蛋白的总量可能不变,但某个位点的磷酸化、糖基化或剪切形式可能显著改变。对于临床标志物来说,这类状态型标志物有时比总蛋白丰度更接近病理机制。
NCI CPTAC 2023 年发布的 pan-cancer proteogenomic dataset 整合了超过 1000 个肿瘤、10 种癌种的基因组、蛋白质组、影像和临床数据,反映出癌症研究正在从单一组学走向蛋白质组、修饰组和临床表型的系统整合。[14]
十二、这类技术目前还有哪些难点?
修饰组学和 proteoform 分析很有前景,但仍然有明显挑战。
1. 覆盖不完整
常规蛋白质组学可以相对容易地覆盖几千到上万个蛋白,但 PTM 和 proteoform 的空间更大,动态范围更宽,低丰度状态更难捕捉。
2. 定量更难
修饰位点变化需要区分两种情况:是蛋白总量变了,还是单位蛋白上的修饰比例变了。理想情况下,修饰肽段定量应结合总蛋白定量一起解释。
3. 位点定位和 FDR 控制更复杂
PTM 分析不仅要鉴定肽段,还要判断修饰位点,错误定位会直接影响功能解释。
4. 功能注释不足
很多 PTM 位点可以被测到,但不知道上游酶、下游功能和疾病意义。2025 年 dark cancer phosphoproteome 工作中提到的大量未注释磷酸化位点,就是这个问题的典型体现。[10]
5. Proteoform 的技术门槛更高
Top-down、native MS、完整蛋白分离和数据解析仍然比 bottom-up 更复杂。2024 年 Nature Methods 对 top-down 样本制备的分析也强调,不同样本制备策略会影响 proteoform 鉴定,说明该领域仍需要系统 benchmark 和标准化。[9]
所以,这一篇要传达一个平衡观点:
修饰组学和 proteoform 是读懂生命状态的关键,但它们还不是“按一下按钮就能得到答案”的成熟黑箱。
它们正在快速发展,也仍然需要谨慎解释。
十三、这一篇的核心结论:蛋白质组学正在从“表达量”走向“状态图谱”
如果用一句话总结第六篇:
蛋白不是一个名字,而是一组动态状态。修饰组学和 proteoform 分析,正是为了读取这些状态。
常规蛋白质组学告诉我们:这个蛋白有没有、丰度多少。
磷酸化组学告诉我们:信号通路是否被激活。
泛素化组学告诉我们:蛋白命运如何被调度。
糖蛋白组学告诉我们:分泌、膜表面和免疫识别如何被调控。
乙酰化、甲基化等修饰告诉我们:染色质、代谢和蛋白互作如何被精细调节。
Top-down 和 proteoform 分析则试图告诉我们:同一个蛋白名下,到底存在哪些完整分子形态。
这一步非常重要。
因为生命状态不是由“蛋白清单”单独决定的,而是由蛋白丰度、修饰、结构、互作、定位和 proteoform 共同决定的。
过去十年,蛋白质组学从“测到更多蛋白”走向“稳定定量蛋白”;现在,它还在继续往前走:
从“蛋白有多少”,走向“蛋白处于什么状态”。
下一篇,我们继续沿着“状态”往空间里走:
蛋白在哪里?空间蛋白质组学为什么成为年度热点。
参考文献与延伸阅读
-
PTMD 2.0: a database for disease-associated post-translational modifications. Nucleic Acids Research. 2025.
https://academic.oup.com/nar/article/53/D1/D554/7779354 -
PTM proteomics review: enrichment and MS/MS strategies for global PTM analysis.
https://pmc.ncbi.nlm.nih.gov/articles/PMC2892724/ -
Lancaster et al. Rapid and deep phosphoproteome profiling by Orbitrap Astral DIA. Nature Communications. 2024.
https://www.nature.com/articles/s41467-024-51274-0 -
Li et al. Proteomics of ubiquitin-like modifications. Nature Reviews Methods Primers. 2021.
https://www.nature.com/articles/s43586-021-00048-9 -
Bagdonaite et al. Glycoproteomics. Nature Reviews Methods Primers. 2022.
https://www.nature.com/articles/s43586-022-00128-4 -
Yang & Fang. DeepGlyco: deep learning prediction of intact glycopeptide spectra. Nature Communications. 2024.
https://www.nature.com/articles/s41467-024-46771-1 -
Modeling fragmentation, elution and glycome connectivity to expand N-glycopeptide identifications. Nature Communications. 2024.
https://www.nature.com/articles/s41467-024-50338-5 -
Roberts et al. Top-down proteomics. Nature Reviews Methods Primers. 2024.
https://www.nature.com/articles/s43586-024-00318-2 -
Kaulich et al. Sample preparation strategies for top-down proteoform identification. Nature Methods. 2024.
https://www.nature.com/articles/s41592-024-02481-6 -
Jiang et al. Machine learning expands the functional landscape of the dark cancer phosphoproteome. Nature Communications. 2025.
https://www.nature.com/articles/s41467-025-57993-2 -
Habeck et al. Community study of native top-down mass spectrometry. Nature Methods. 2024.
https://www.nature.com/articles/s41592-024-02279-6 -
Human Proteoform Project: building a high-quality human proteoform atlas.
https://pmc.ncbi.nlm.nih.gov/articles/PMC8589312/ -
Native top-down MS and hidden modifications in intact protein complexes. Nature Methods. 2025.
https://www.nature.com/articles/s41592-025-02846-5 -
NCI CPTAC pan-cancer proteogenomic dataset release. 2023.
https://www.cancer.gov/news-events/press-releases/2023/cptac-proteogenomic-dataset