从一小块组织到一个细胞:低输入蛋白质组学的十年进化
导读
前几篇里,我们一直在讲蛋白质组学的“规模化”:质谱平台变快,DIA 让定量更稳,高通量工作流让成百上千个样本进入实验设计。
这一篇换一个方向:蛋白质组学不仅在变快、变深、变稳,它也在不断降低样本门槛,从大量细胞和组织块,走向微量组织、FFPE、激光显微切割区域、稀有细胞群,最终走向单细胞。
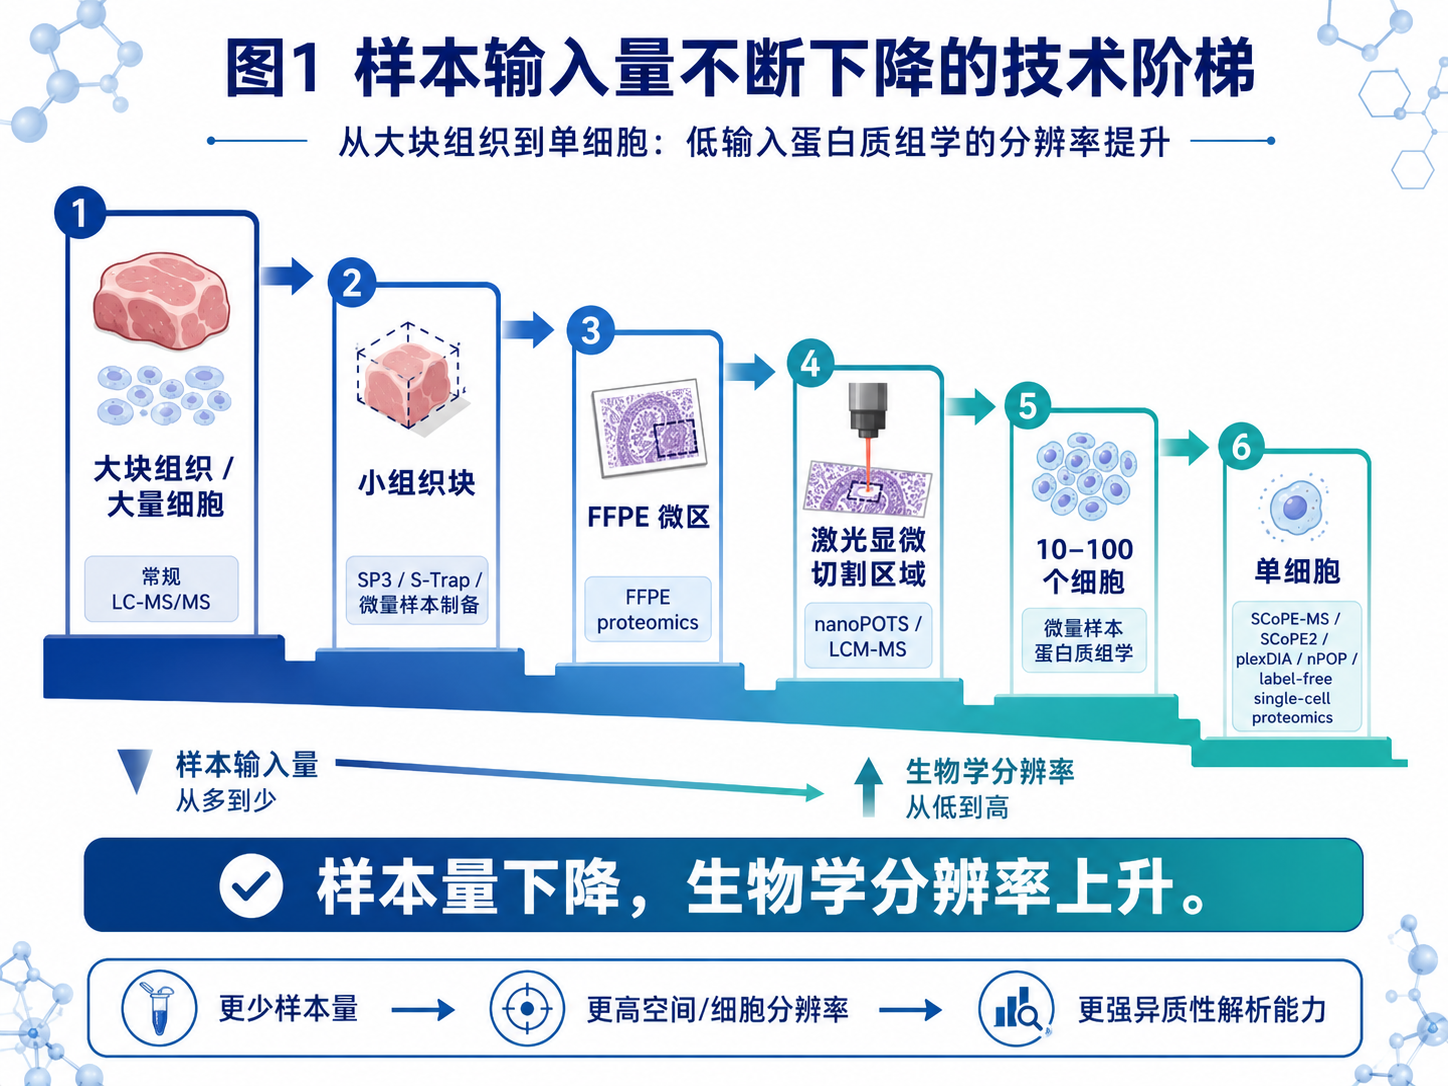
01|另一条技术主线:样本量越来越少
过去,做一次深度蛋白质组学,常常需要大量细胞或足够大的组织块。样本要够多,蛋白量要够高,肽段损失要能承受,低丰度信号才有机会被质谱仪捕捉到。
但真实生命科学和临床研究里,很多最关键的问题并不会给我们那么多样本。
一块肿瘤组织里,真正决定复发和耐药的可能只是一小群细胞。
一张病理切片上,最有价值的信息可能藏在侵袭前沿、免疫边界或血管周围区域。
一个早期胚胎、一群稀有免疫细胞、一次激光显微切割得到的微区组织,都不可能像培养皿里的细胞系那样“随便取样”。
如果要理解细胞异质性,最终还必须面对一个更极端的问题:一个细胞里到底有多少蛋白可以被可靠测量?
这就是低输入蛋白质组学和单细胞蛋白质组学的意义。
它们不是简单地把样本量缩小,而是在改变蛋白质组学能回答的问题:从“这个样本整体发生了什么”,走向“这个细胞群、这个组织微区、甚至这个单个细胞处于什么状态”。
02|为什么蛋白质组学过去很怕小样本?
蛋白质组学天然不喜欢小样本。
原因很直接:蛋白质不能像 DNA 那样扩增。
做基因组或转录组时,研究者可以通过 PCR 或反转录扩增把信号放大;但蛋白质组学面对的是样本中真实存在的蛋白和肽段。少一个细胞,就少一份蛋白;前处理过程中损失一点,质谱仪最终能看到的信号就少一点。
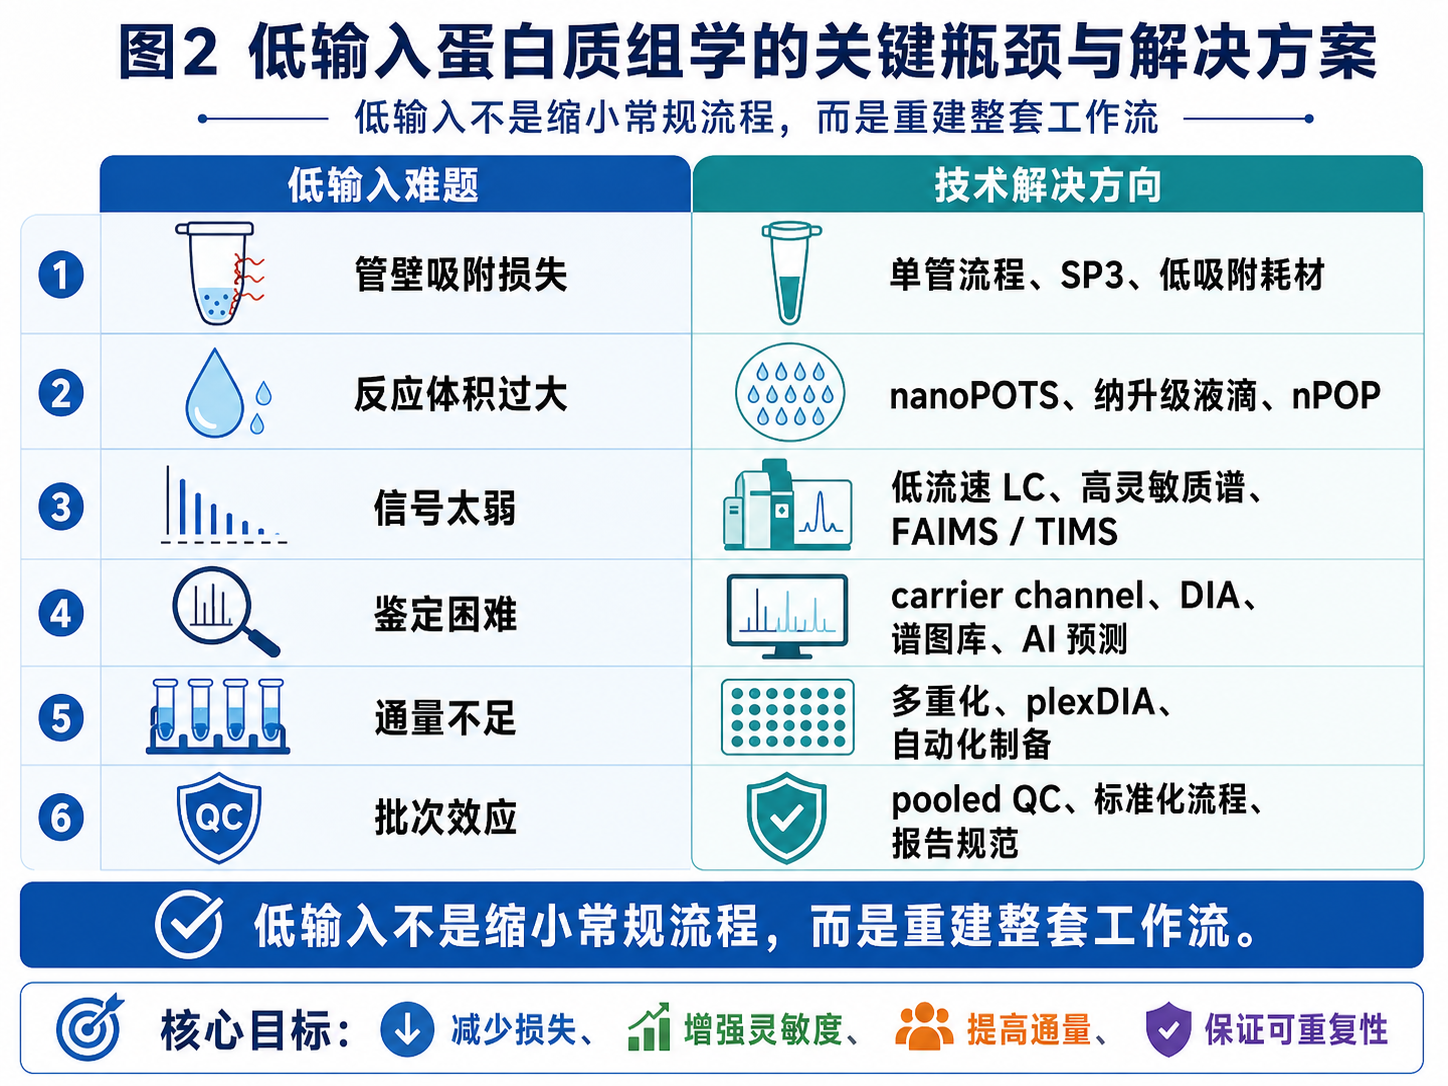
小样本蛋白质组学有几个典型难题。
-
吸附损失。
蛋白和肽段会粘在管壁、枪头、板孔和各种界面上。样本量大时,这点损失可以忽略;样本量小时,可能就是致命损失。 -
消化效率不稳定。
蛋白裂解、还原、烷基化、酶切都需要合适的化学环境。体积太小、蛋白太少,任何一步的波动都会放大。 -
污染更明显。
角蛋白、BSA、塑料耗材污染、试剂背景,在常规样本中可能只是小问题;在单细胞或微量样本里,背景信号可能直接压过真实信号。 -
质谱信号太弱。
一个哺乳动物细胞内的蛋白量非常有限。进入质谱仪的可用肽段越少,对离子化效率、离子传输效率、扫描策略和数据分析的要求就越高。 -
缺失值和批次效应更难处理。
低输入样本的信号本来就接近检测边界。如果没有严格质控,很容易把技术噪声误认为生物差异。
所以,低输入蛋白质组学的核心问题不是“把常规流程缩小十倍”这么简单,而是要重建一整套适合微量样本的流程。
03|第一步:减少损失,让少量蛋白不要消失在管壁上
低输入蛋白质组学的第一场战役,发生在样本制备环节。
很多时候,样本不是死在质谱仪里,而是死在上机之前。蛋白提取、洗涤、转移、脱盐、干燥、复溶,每一步都可能造成损失。对于微量样本来说,“少转移一次”“少换一个管”“少暴露一个界面”,都可能决定最终能否测到足够多蛋白。
SP3 是这一方向的代表性方法之一。
SP3 全称 single-pot, solid-phase-enhanced sample preparation,利用顺磁珠对蛋白进行捕获、洗涤和释放,可以在单管中完成清理和制备,兼容多种裂解和变性条件,并强调近乎无损、无偏的蛋白回收。2019 年 Nature Protocols 文章将 SP3 描述为一种快速、稳健、灵活的蛋白质组样本制备方法,适用于从大样本到非常小样本的多类场景。[1]
这类方法的意义,在于把低输入蛋白质组学从“靠手艺”推进到“靠流程”。
过去微量样本处理很容易依赖经验:枪头怎么润洗,样本怎么转移,干燥到什么程度,复溶多久。现在,越来越多方法试图用更少转移、更小体积、更标准化的反应体系来减少人为波动。
除了 SP3,S-Trap、FASP、StageTip、iST、mPOP、nPOP 等方法或工作流也都在围绕同一个目标迭代:
让有限的蛋白尽可能进入质谱,而不是损失在前处理过程中。
04|第二步:把反应体积缩小到纳升级
减少损失的一种直接思路,是把反应体积做小。
因为体积越大,样本越稀,分子接触界面越多,损失越难控制。对于微量蛋白质组学来说,纳升级样本处理的意义非常大。
nanoPOTS 是低输入蛋白质组学的重要里程碑。
nanoPOTS 全称 Nanodroplet Processing in One pot for Trace Samples,它通过微加工纳米孔芯片和纳升级液体处理,把样本制备体积降到极小,从而减少表面吸附损失。2018 年 Nature Communications 论文介绍了 nanoPOTS 平台,强调它通过把处理体积缩小到 200 nL 以下,提高微量样本处理效率和回收率。[2]
在 10–100 个细胞级别的样本中,nanoPOTS 这类平台让蛋白质组学开始进入过去难以触及的区域。PNNL 对该工作的介绍显示,nanoPOTS 可以从约 10 到 140 个细胞中鉴定约 1500 到 3000 个蛋白,并用于胰岛组织薄切片等空间相关微区样本分析。[3]
这一步非常关键。
因为低输入蛋白质组学真正关心的不是“样本更少也能测”这个技术噱头,而是它打开了新的生物学场景:稀有细胞群、微区组织、临床小活检、早期发育样本、细胞亚群和空间异质性区域。
如果常规蛋白质组学像是在测一整杯水的成分,那么 nanoPOTS 这样的技术更像是在分析一滴水甚至一小滴水里的分子组成。
05|第三步:从组织块走向微区组织和 FFPE 样本
低输入蛋白质组学的另一个重要方向,是临床组织。
临床研究中,最有价值的样本往往不是新鲜、大量、完美保存的材料,而是病理科保存多年的 FFPE 组织、手术切片、小活检和回顾性队列样本。
FFPE,也就是 formalin-fixed paraffin-embedded,中文常说福尔马林固定石蜡包埋组织。它是病理诊断中最常见的样本保存方式,优点是临床资源丰富,缺点是固定和交联会增加蛋白提取和质谱分析难度。
过去,FFPE 更常用于病理染色、免疫组化和部分基因检测。随着样本制备和质谱方法进步,FFPE 蛋白质组学开始成为临床回顾性研究的重要入口。
2021 年 Nature Communications 的一项研究系统评估了 FFPE 肺癌组织的蛋白质组和磷酸化蛋白质组分析,展示了在 FFPE 肺鳞癌和肺腺癌中使用 TMT 方法定量超过 8000 个蛋白和超过 14000 个磷酸化位点,并进一步提出微尺度流程用于有限组织量的 FFPE 样本。[4]
这类工作的意义,不只是技术上“FFPE 也能测蛋白”。
它让大量临床档案样本有机会被重新打开。过去只能看形态、免疫组化和少数分子标志物的样本,现在有机会进入全蛋白质组和信号通路层面的分析。
与此相关的另一个方向,是激光显微切割,也就是 LCM / LMD。
传统组织蛋白质组学常常把一块组织整体打碎,得到的是平均信号。可是肿瘤组织里有肿瘤细胞、免疫细胞、基质细胞、血管、坏死区域和侵袭前沿。整体打碎后,关键局部信号可能被平均掉。
激光显微切割可以在显微镜下选择特定区域或特定细胞群,把组织空间信息和质谱蛋白质组学连接起来。2022 年的 Deep Visual Proteomics 就把 AI 图像分析、自动化激光显微切割和超高灵敏质谱结合起来,用于在保留空间上下文的情况下分析细胞状态和组织异质性。[9]
虽然空间蛋白质组学会在后面的第七篇重点讲,但这里可以先埋一个伏笔:
低输入能力是空间蛋白质组学的重要前提。
如果没有微量样本处理能力,我们就只能测大块组织;如果能测几十个细胞、十几个细胞甚至单个细胞,组织切片上的空间结构才真正能被蛋白质组学读取。
06|第四步:单细胞蛋白质组学出现,问题变成“一个细胞能不能测?”
低输入蛋白质组学继续往前走,就会碰到一个极限问题:
单个细胞。
单细胞 RNA 测序已经深刻改变了生命科学,因为它让我们看到细胞群体内部的异质性。但是 RNA 并不等于蛋白,mRNA 丰度也不总能直接代表蛋白丰度。蛋白才是多数细胞功能的直接执行者,很多关键状态还取决于蛋白修饰、降解、定位和复合物状态。
因此,单细胞蛋白质组学的目标非常诱人:不依赖抗体预设目标,直接用质谱在单个细胞层面测量尽可能多的蛋白。
SCoPE-MS 是这个方向的重要里程碑之一。2018 年 Genome Biology 论文提出 SCoPE-MS,利用同位素标签和 carrier channel 的策略,将少量单细胞信号与载体样本一起分析,并在分化中的小鼠胚胎干细胞中定量超过 1000 个蛋白,用于解析细胞群体异质性。[5]
SCoPE-MS 的核心思想很巧妙:单个细胞的肽段太少,很难触发稳定的质谱鉴定;但如果加入一个由较多细胞组成的 carrier channel,就可以提高肽段识别能力,而单个细胞通道则用于定量。
随后,SCoPE2 对流程进行了改进,用于单细胞蛋白质组和转录组联合分析,并应用于巨噬细胞异质性研究。[6]
这里有一个适合公众号读者理解的比喻:
SCoPE-MS 像是在一场很嘈杂的音乐会里,先用合唱团帮你确认旋律,再去听每个独唱者唱得有什么不同。
carrier channel 帮助质谱仪知道“这里有这个肽段”,单细胞通道则告诉我们“每个细胞里这个肽段有多少”。
07|单细胞蛋白质组学不是只有一条路线
单细胞蛋白质组学并不是一种单一技术,而是一组路线。
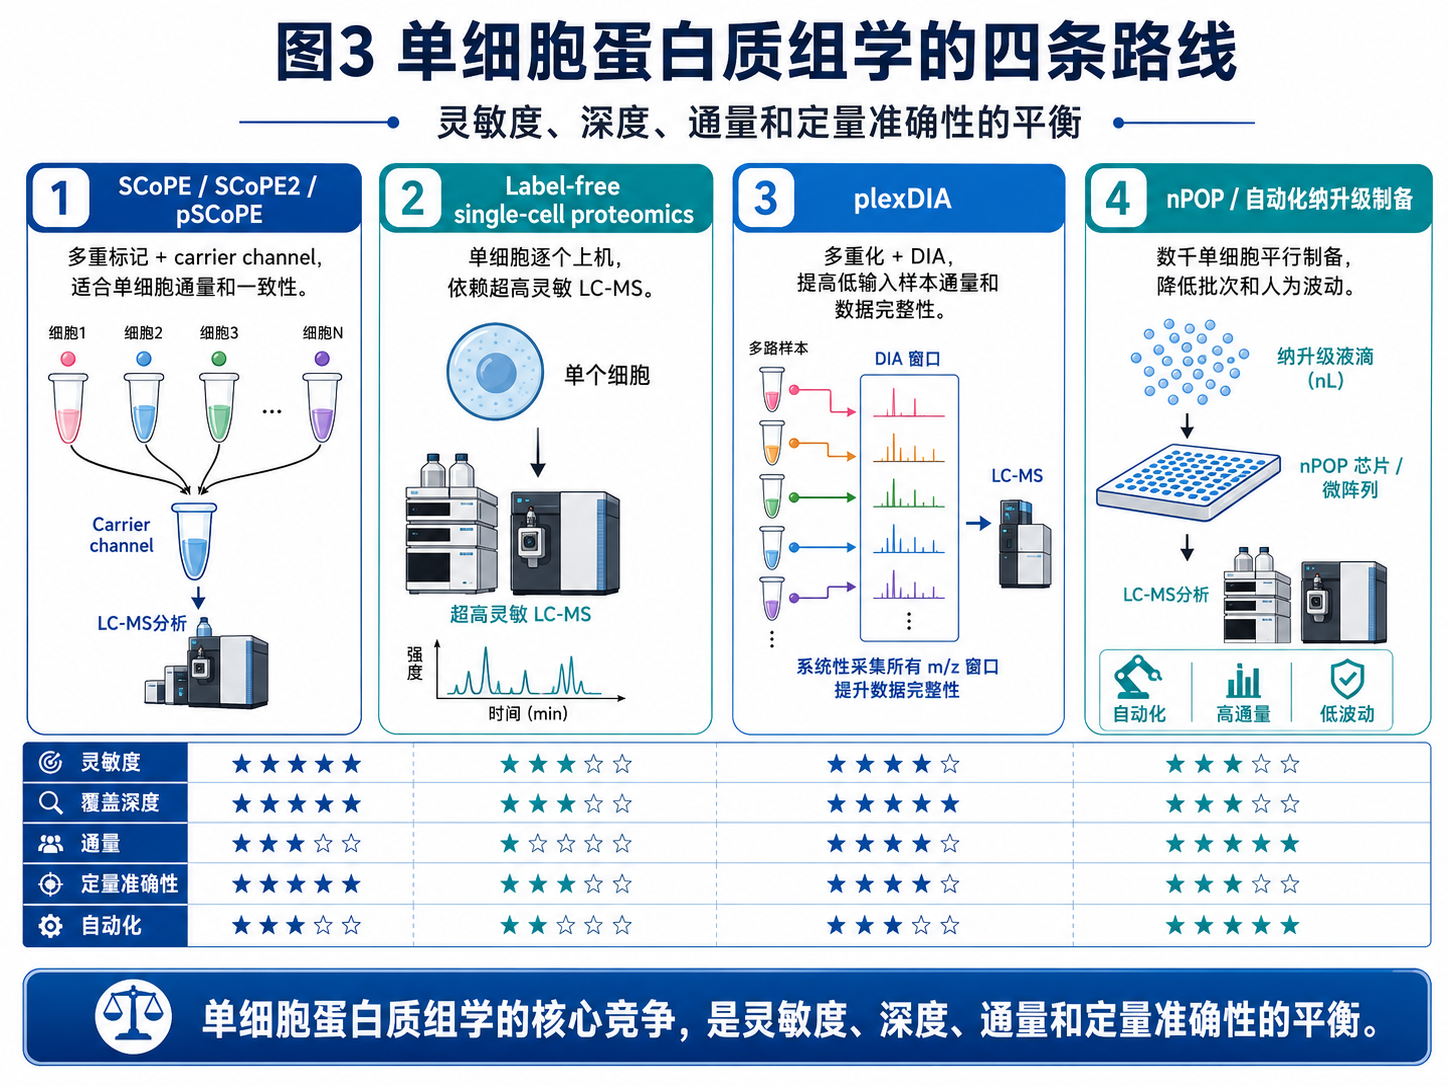
1. 标记多重化路线:SCoPE / SCoPE2 / pSCoPE
这一类方法通常利用 TMT 或类似标记,把多个单细胞和 carrier 样本合并分析。
它的优势是多重化和通量,挑战是 carrier channel 设计、缺失值、ratio compression 和定量准确性。
pSCoPE 是这一方向的进一步发展。2023 年 Nature Methods 论文提出 prioritized Single-Cell ProtEomics,通过优先级采集策略提高单细胞蛋白质组的深度、敏感性和数据完整性,目标是在尽量保持通量的同时,把仪器时间更多用于真正有价值的肽段。[10]
2. Label-free single-cell proteomics
第二类是 label-free 单细胞路线,也就是每个单细胞单独测。
它避免了部分标记和 carrier 相关问题,但对质谱灵敏度、色谱稳定性和运行通量要求极高。2022 年 Molecular Systems Biology 的一项研究结合微型化样本制备、低流速色谱和 trapped ion mobility 质谱,报告灵敏度提升超过 10 倍,并在超过 430 个单细胞蛋白质组中分析细胞周期扰动。[7]
3. plexDIA:多重化 + DIA
第三类是 DIA 和多重化结合路线,例如 plexDIA。
plexDIA 通过非等obaric 标签把多个样本与 DIA 结合,在低输入样本中提高通量和数据完整性。2022 年上线、2023 年正式发表的 Nature Biotechnology 论文显示,plexDIA 在 1 小时 active gradient 中可在三重标记样本中定量约 8000 个蛋白;应用于单个人类细胞时,可在每个细胞约 5 分钟 active chromatography 条件下定量约 1000 个蛋白,并达到较高数据完整性。[8]
4. nPOP / 自动化纳升级制备
第四类是自动化纳升级样本制备路线,例如 nPOP。
nPOP 使用皮升级 / 纳升级液滴和自动化分液,在玻片上平行处理大量单细胞。2022 年 Genome Biology 论文介绍,nPOP 可以在 8–20 nL 体积中同时制备数千个单细胞,包括裂解、消化和标记,并用于研究细胞周期和黑色素瘤耐药相关状态中的蛋白共变关系。[11]
这几条路线背后的共同目标是一样的:
既要足够灵敏,又要足够稳定;既要能测一个细胞,又要能测很多细胞。
因为单细胞研究只测几个细胞意义有限。真正有价值的是在成百上千个细胞中比较细胞状态、细胞周期、药物响应、分化轨迹和稀有亚群。
08|近年趋势:从“能不能测”进入“怎么测得更深、更准、更高通量”
如果说 2018 年前后的问题是“单细胞蛋白质组学是否可行”,那么近几年的问题已经变成:
能不能测得更深、更准、更高通量?
2025 年 Nature Methods 上出现了两个很有代表性的进展。
一个是 Orbitrap Astral 相关单细胞工作。该研究展示了超低输入条件下更深的蛋白质组覆盖:使用定制谱图库时,可从 250 pg HeLa 肽段中鉴定最高 7400 个 protein groups,并强调在单细胞输入水平上检查定量准确性和精密度。[12]
另一项 Chip-Tip 工作则展示了 label-free 单细胞蛋白质组学的深度覆盖路线。该工作通过 Chip-Tip workflow 提升灵敏度与可扩展性,推动 deep single-cell proteomics 的 label-free 工作流发展。[13]
这些进展说明,单细胞质谱蛋白质组学正在从“证明可以测”转向“追求可用的深度、准确性和规模”。
不过,这里需要谨慎表达。公众号里可以写趋势,但不要让读者误解为“单细胞蛋白质组学已经像单细胞 RNA-seq 一样成熟”。事实上,它仍然是快速发展中的高门槛技术,对仪器、样本制备、数据分析和质控都有很高要求。
2023 年 Nature Methods 的单细胞蛋白质组学报告建议也强调,单细胞质谱蛋白质组学虽然已经技术可行,但准确性和可重复性会受到实验设计、样本制备、数据采集和数据分析等多环节影响,因此需要标准化指标、质量控制和报告规范。[14]
换句话说,这个领域已经从“能不能测”进入“怎么测得可信”。
09|低输入蛋白质组学真正改变了什么?
低输入蛋白质组学最大的价值,不是把样本量做小,而是把生物学问题做细。
它至少改变了四类研究场景。
1. 稀有细胞群
很多关键细胞在样本中占比很低,例如肿瘤干样细胞、耐药亚群、迁移中的免疫细胞、早期分化细胞、胚胎发育阶段的特定细胞群。过去如果需要大量细胞,这些群体很难被单独测量。低输入技术让它们可以从“被平均掉”变成“被单独看见”。
2. 临床小样本
很多临床样本无法大量获取。小活检、穿刺样本、早期病灶、珍贵队列样本和 FFPE 档案组织,都需要低输入流程。FFPE 蛋白质组学的发展尤其重要,因为它连接了真实临床病理资源和系统分子分析。[4]
3. 组织空间微区
肿瘤侵袭前沿、免疫细胞浸润区域、坏死边界、血管周围区域、神经组织中特定层次,都不是大块组织平均值能解释的。Deep Visual Proteomics 这类方法把图像、AI、显微切割和质谱连接起来,说明低输入蛋白质组学正在成为空间蛋白质组学的一部分。[9]
4. 单细胞异质性
细胞群体中每个细胞并不相同。它们可能处在不同细胞周期阶段,有不同应激反应、分化方向、药物敏感性和代谢状态。单细胞蛋白质组学的目标,是直接在蛋白层面读取这些差异,而不只依赖 RNA 或少数抗体标志物。
所以,这一篇的核心不是“样本越来越少”,而是:
蛋白质组学的分辨率越来越高。
10|低输入和单细胞蛋白质组学还有哪些难题?
这一节很重要,因为不能把领域讲得过于完美。
1. 覆盖深度
单细胞里蛋白量有限,不可能像 bulk 样本那样轻松覆盖上万个蛋白。虽然 2025 年已有单细胞和超低输入层面深覆盖的报道,但这通常依赖高端仪器、优化流程、特定细胞和严格条件;普通实验室常规应用仍需要时间。[12][13]
2. 定量准确性
低输入信号弱,噪声、污染、缺失值和批次效应都会影响定量。SCoPE 类方法还需要处理 carrier channel 对鉴定和定量的影响,label-free 单细胞路线则要面对运行通量和仪器稳定性问题。
3. 通量
单细胞研究需要大量细胞。只测几十个细胞很难支撑复杂生物学结论。nPOP、plexDIA、pSCoPE 等方法都在提高通量,但如何在深度、准确性和样本数之间平衡,仍然是核心挑战。[8][10][11]
4. 标准化和可重复性
单细胞蛋白质组学涉及很多可变环节:细胞分选、裂解、酶切、标记、LC-MS、数据搜索、归一化、缺失值处理和批次校正。2023 年的社区建议强调,需要统一的实验报告、benchmark 和质量控制指标,以提升不同实验室之间的可比性。[14]
5. 数据整合
随着单细胞和空间蛋白质组学快速发展,数据不配对、跨实验整合、多模态映射和空间上下文解释会越来越重要。2026 年 Nature Biotechnology 的一篇 correspondence 指出,单细胞和空间蛋白质组学正在快速成熟,但进展越来越受限于跨实验、跨模态和跨空间背景的数据整合能力。[15]
因此,低输入蛋白质组学不是一个已经完成的领域,而是一个正在快速成熟的前沿。
11|这一篇的核心结论:样本量下降,问题精度上升
如果用一句话总结这一篇:
低输入蛋白质组学的本质,不是“用更少样本做同样的事”,而是“让蛋白质组学进入过去看不见的细胞群、组织微区和单细胞状态”。
SP3、nanoPOTS、nPOP 等方法减少了样本处理损失。
FFPE 和微尺度组织蛋白质组学打开了临床档案样本。
激光显微切割和 Deep Visual Proteomics 让蛋白质组学开始保留空间信息。
SCoPE-MS、SCoPE2、pSCoPE、plexDIA 和 label-free 单细胞路线,把质谱推向单细胞层面。
Orbitrap Astral 和 Chip-Tip 等新进展,则显示单细胞蛋白质组学正在进入更深覆盖阶段。
过去,蛋白质组学常常告诉我们一个样本的平均状态。
现在,它开始追问:
- 这个组织中哪一小块区域变了?
- 这个细胞群中哪一类细胞变了?
- 同一类细胞里,哪些细胞已经进入了不同状态?
- 这些状态能否在蛋白层面被直接读出来?
这就是低输入蛋白质组学的真正意义。
它让蛋白质组学从“整体平均值”,走向“细胞分辨率”。
下一篇,我们继续从“蛋白有多少”进入“蛋白处于什么状态”:
蛋白不是一个名字:修饰组学和 Proteoform 为什么重要。
参考文献线索
[1] Hughes CS, et al. Single-pot, solid-phase-enhanced sample preparation for proteomics experiments. Nature Protocols, 2019.
https://www.nature.com/articles/s41596-018-0082-x
[2] Zhu Y, et al. Nanodroplet processing platform for deep and quantitative proteome profiling of 10–100 mammalian cells. Nature Communications, 2018.
https://www.nature.com/articles/s41467-018-03367-w
[3] PNNL. Nanodroplet processing platform for deep and quantitative proteome profiling of 10–100 mammalian cells.
https://www.pnnl.gov/publications/nanodroplet-processing-platform-deep-and-quantitative-proteome-profiling-10-100
[4] Friedrich C, et al. Comprehensive micro-scaled proteome and phosphoproteome characterization of archived retrospective cancer repositories. Nature Communications, 2021.
https://www.nature.com/articles/s41467-021-23855-w
[5] Budnik B, et al. SCoPE-MS: mass spectrometry of single mammalian cells quantifies proteome heterogeneity during cell differentiation. Genome Biology, 2018.
https://genomebiology.biomedcentral.com/articles/10.1186/s13059-018-1547-5
[6] Specht H, et al. Single-cell proteomic and transcriptomic analysis of macrophage heterogeneity using SCoPE2. Genome Biology, 2021.
https://genomebiology.biomedcentral.com/articles/10.1186/s13059-021-02267-5
[7] Brunner AD, et al. Ultra-high sensitivity mass spectrometry quantifies single-cell proteome changes upon perturbation. Molecular Systems Biology, 2022.
https://link.springer.com/article/10.15252/msb.202110798
[8] Derks J, et al. Increasing the throughput of sensitive proteomics by plexDIA. Nature Biotechnology, 2022 / 2023.
https://www.nature.com/articles/s41587-022-01389-w
[9] Mund A, et al. Deep Visual Proteomics defines single-cell identity and heterogeneity. Nature Biotechnology, 2022.
https://www.nature.com/articles/s41587-022-01302-5
[10] Petelski AA, et al. Multiplexed single-cell proteomics using SCoPE2 and pSCoPE. Nature Methods, 2023.
https://www.nature.com/articles/s41592-023-01830-1
[11] Leduc A, et al. Exploring functional protein covariation across single cells using nPOP. Genome Biology, 2022.
https://genomebiology.biomedcentral.com/articles/10.1186/s13059-022-02817-5
[12] Matzinger M, et al. Challenging the Astral mass analyzer to quantify up to 5,300 proteins per single cell at unseen accuracy to uncover cellular heterogeneity. Nature Methods, 2025.
https://www.nature.com/articles/s41592-024-02559-1
[13] Ye Z, et al. Enhanced sensitivity and scalability with a Chip-Tip workflow enables deep single-cell proteomics. Nature Methods, 2025.
https://www.nature.com/articles/s41592-024-02558-2
[14] Gatto L, et al. Initial recommendations for performing, benchmarking and reporting single-cell proteomics experiments. Nature Methods, 2023.
https://www.nature.com/articles/s41592-023-01785-3
[15] Koutrouli M, et al. Unpaired data as a first-order challenge in single-cell and spatial proteomics. Nature Biotechnology, 2026.
https://www.nature.com/articles/s41587-026-03074-8