蛋白质组学不只做清单:结构、互作和机制解析的新工具箱
系列第八篇
前面几篇,我们已经讲了蛋白质组学如何测得更快、更稳、更多、更小,也讲了蛋白修饰、proteoform 和空间位置。
这一篇继续往机制层面推进:蛋白质组学不只告诉我们“有哪些蛋白”,还可以追问 蛋白如何变形、和谁结合、组成什么复合物、药物是否真正击中靶点。
本文导读
前面几篇里,我们已经讲了蛋白质组学的几个关键升级:
- 仪器更快了;
- DIA 让定量更稳了;
- 高通量让样本更多了;
- 低输入和单细胞让样本更小了;
- 修饰组学让我们看到蛋白状态;
- 空间蛋白质组学让我们知道蛋白在哪里。
但生命科学真正关心的,往往不只是“蛋白有没有变化”。
更关键的问题是:
- 这个蛋白为什么变化?
- 它和谁结合?
- 它是否改变构象?
- 它是否进入某个复合物?
- 药物是否真正打到了它?
- 通路变化是直接作用,还是下游连锁反应?
- 一个疾病表型背后,真正的分子机制是什么?
这就是第八篇要讲的主题:
蛋白质组学如何从“分子清单”,走向“机制解析”。
过去十年,质谱蛋白质组学不再只是大规模鉴定和定量蛋白。它正在和结构生物学、化学生物学、细胞生物学、AI 结构预测、药物研发结合,形成一套新的机制工具箱。
这套工具箱里有很多方法:XL-MS、HDX-MS、LiP-MS、native MS、AP-MS、DIP-MS、proximity labeling、TPP、CETSA、photoaffinity labeling……
这些名字看起来复杂,但它们都在回答同一个问题:
蛋白质不只是“有多少”,还要知道它如何工作。
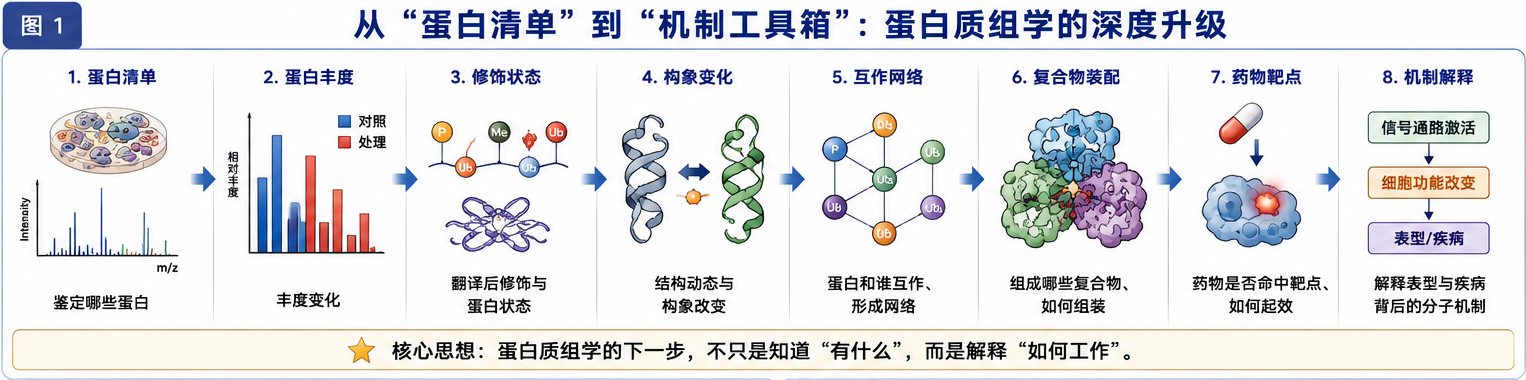
图 1|从“蛋白清单”到“机制工具箱”
蛋白质组学的下一步,不只是知道“有什么”,而是解释“如何工作”。
一、为什么“蛋白清单”不够?
常规蛋白质组学最擅长回答两个问题:
- 这个样本里有哪些蛋白?
- 这些蛋白丰度发生了什么变化?
这已经很有价值。
比如,一个肿瘤样本中某些代谢酶上调,某些免疫相关蛋白增加,某些细胞外基质蛋白升高,这些都能提示疾病状态。
但真正做机制研究时,我们常常会遇到更深的问题。
一个蛋白丰度升高,不代表它一定活跃。一个通路蛋白没有变化,也不代表通路没有被激活。一个药物处理后某个蛋白变化,不代表药物直接结合了它。一个蛋白被鉴定为“互作蛋白”,也不代表它们在细胞里真实组成同一个复合物。一个 AI 预测结构很漂亮,也不代表它能解释细胞内的动态构象和多蛋白组装。
所以,蛋白质组学要走向机制,至少要增加几类信息:
| 问题 | 需要的机制信息 |
|---|---|
| 蛋白是否改变构象? | HDX-MS、LiP-MS、XL-MS |
| 蛋白和谁结合? | AP-MS、proximity labeling、XL-MS、DIP-MS |
| 复合物由哪些亚基组成? | Native MS、BN-PAGE-MS、SEC-MS、DIP-MS |
| 药物是否结合靶点? | CETSA、TPP、LiP-MS、photoaffinity labeling |
| 蛋白结构模型是否可信? | AlphaFold + XL-MS / HDX-MS / native MS 验证 |
| 通路变化是否是直接机制? | 靶点验证 + 互作网络 + 修饰组学 |
这也是为什么这一篇叫“新工具箱”。
我们不是在讲一种技术,而是在讲一组帮助蛋白质组学进入机制层面的工具。
二、结构蛋白质组学:从序列和丰度走向构象和复合物
传统结构生物学依赖 X-ray、NMR、cryo-EM 等方法,能够解析高分辨率蛋白结构。它们非常强大,但也常常面对一些限制:样本制备要求高,复杂复合物难处理,动态构象难捕捉,很多蛋白在细胞内的真实状态不容易重建。
质谱进入结构生物学之后,带来了另一种思路。
它不一定直接给出原子级结构,但可以提供大量结构约束和状态信息,比如:
- 哪些氨基酸残基彼此接近?
- 蛋白哪些区域暴露在溶剂中?
- 配体结合后哪些区域稳定性改变?
- 复合物有哪些亚基?
- 亚基之间的拓扑关系是什么?
- 蛋白在细胞内是否处于不同构象?
这类方法常被称为 structural proteomics 或 structural mass spectrometry。
在这个工具箱里,最常见的几类方法是:
| 方法 | 核心读数 | 适合回答的问题 |
|---|---|---|
| XL-MS | 残基之间的距离约束 | 蛋白折叠、复合物拓扑、互作界面 |
| HDX-MS | 氢氘交换速率 | 构象动态、结合区域、变构效应 |
| LiP-MS | 蛋白酶切敏感性变化 | 构象改变、药物靶点、蛋白状态 |
| Native MS | 完整复合物质量和组成 | 亚基组成、化学计量、复合物状态 |
| Top-down / native top-down | 完整 proteoform / 复合物 | 修饰组合、完整形态、复合物中的 proteoform |
这些方法的共同特点是:它们不只是测“蛋白有多少”,而是在测蛋白的物理状态。
这一步非常重要。因为生命活动最终不是由蛋白清单执行的,而是由折叠、构象、互作、复合物和动态调控执行的。
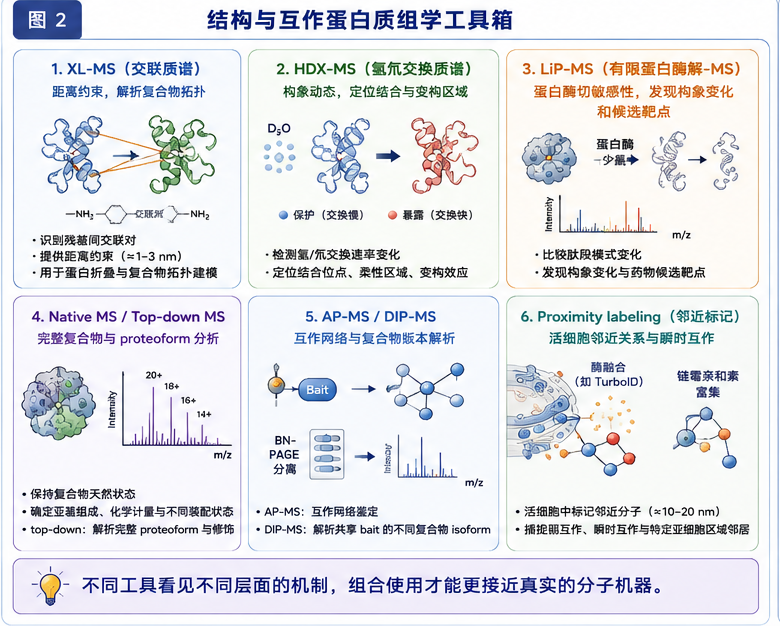
图 2|结构与互作蛋白质组学工具箱
不同工具看见不同层面的机制,组合使用才能更接近真实分子机器。
三、XL-MS:给蛋白和复合物加上“距离尺”
XL-MS,全称 cross-linking mass spectrometry,中文常译为交联质谱。
它的基本思路是:用化学交联剂把空间上相近的氨基酸残基“固定”在一起,然后通过质谱识别哪些残基被连接。这样,研究者就能得到一组距离约束。
可以把 XL-MS 想象成给蛋白结构加上很多“短尺子”。
如果两个残基能被交联,说明它们在空间上足够接近。如果两个蛋白之间出现交联,说明它们可能存在直接接触或非常近的空间关系。如果某种处理前后交联模式改变,说明蛋白构象或复合物拓扑可能发生变化。
2018 年 Nature Structural & Molecular Biology 综述指出,cross-linking mass spectrometry 已经发展成为一种能够提供中等分辨率结构信息的工具,可以通过氨基酸残基之间的空间接近关系,帮助理解蛋白折叠和复合物拓扑。[1]
XL-MS 的价值在于,它适合研究“大而复杂”的分子机器。
比如核孔复合物、蛋白酶体、核糖体、转录复合物、染色质调控复合物、线粒体复合物。这些体系往往太大、太动态、太复杂,单靠传统结构生物学不容易完整解析。XL-MS 可以提供距离约束,再与 cryo-EM、AlphaFold、分子建模等方法结合,形成整合结构模型。
过去几年,XL-MS 还在向两个方向发展。
第一个方向是蛋白质组范围的互作和结构约束。2024 年 Nature Methods 发表的工作构建了用于 proteome-wide XL-MS 的重组蛋白标准,并开发了 Scout 搜索引擎,用于提升交联质谱数据分析工具的评估和性能。[2]
第二个方向是活细胞或近生理状态中的交联。2025 年 Current Opinion in Chemical Biology 综述指出,in vivo XL-MS 正在成为解析活细胞中蛋白构象动态和复杂调控网络的高通量方法,因为它能够在接近生理条件下提供蛋白内部构象和蛋白间互作的距离约束。[3]
XL-MS 也和 AI 结构预测形成了新的互补关系。
AlphaFold 改变了蛋白结构预测领域。2021 年 Nature 论文展示了 AlphaFold 能够仅根据氨基酸序列高精度预测蛋白三维结构,在结构生物学中产生了巨大影响。[16] 但 AI 预测结构并不自动等于细胞内真实构象,尤其是动态区域、多构象蛋白和复合物装配。2023 年 Nature Methods 报道的 AlphaLink 就是一个代表:它把 cross-linking MS 的实验距离约束整合进 AlphaFold2 架构,用实验数据帮助结构模型更接近溶液中的构象。[17]
所以,XL-MS 的意义不是取代 AlphaFold,而是给 AI 模型加上实验锚点。
AI 负责预测,XL-MS 负责约束和验证。
四、HDX-MS:观察蛋白如何呼吸、打开和结合
HDX-MS,全称 hydrogen–deuterium exchange mass spectrometry,中文常译为氢氘交换质谱。
它测的不是蛋白“有多少”,而是蛋白骨架酰胺氢和溶剂中氘之间交换的速度。
这个交换速度和蛋白结构有关。
如果某个区域埋在蛋白内部,或者参与稳定氢键网络,氢氘交换会比较慢。如果某个区域暴露在溶剂中,或者结构比较松散,交换会比较快。如果配体、抗体、药物或另一个蛋白结合后让某个区域变得更稳定,交换速率会发生变化。
所以,HDX-MS 像是在观察蛋白的“呼吸”。
它特别适合回答这些问题:
- 蛋白哪些区域是柔性的?
- 配体结合在哪里?
- 抗体表位在哪里?
- 复合物形成后哪些区域被保护?
- 突变是否改变构象动态?
- 药物是否引起变构效应?
Nature Methods 的 HDX-MS 社区建议文章指出,HDX-MS 可以作为结构、构象动态和功能之间的桥梁,用于研究蛋白构象、结合位点、变构效应、蛋白折叠、无序区域和蛋白–膜相互作用等问题。[4]
这类信息对药物研发尤其重要。
很多药物不是简单占据一个活性位点,而是改变蛋白构象、稳定某个状态、阻断某个界面,或者通过变构效应影响功能。HDX-MS 可以帮助研究者看到药物结合后蛋白哪些区域发生了动态变化。
过去 HDX-MS 的一个瓶颈是数据处理和人工校验。2024 年 Nature Communications 发表的 HX-MS² 工作把 HDX 与 DIA 思想结合,利用碎片离子信息同时确认肽段身份和氘代计算,从而推动 HDX 数据分析的自动化。[5]
这说明结构蛋白质组学也在沿着前几篇讲过的方向发展:
- 更自动化;
- 更高通量;
- 更依赖 DIA 和计算方法;
- 更适合复杂样本和药物筛选。
五、LiP-MS:用“蛋白酶敏感性”发现构象变化和药物靶点
LiP-MS,全称 limited proteolysis coupled mass spectrometry,中文可以理解为有限蛋白酶解偶联质谱。
它的逻辑很巧妙。
蛋白质折叠之后,有些区域暴露在外,有些区域藏在内部;有些区域柔性大,有些区域结构稳定。蛋白酶更容易切到暴露、柔性的区域。如果蛋白结合药物、发生突变、进入复合物或改变构象,蛋白酶切位点的可及性就可能改变。
LiP-MS 就是利用这个特点:先进行温和的有限酶切,再用质谱比较不同条件下肽段模式的变化,从而推断蛋白构象或状态变化。
它适合回答:
- 药物处理后,哪些蛋白构象发生变化?
- 这个小分子的直接或候选靶点是什么?
- 某个突变是否改变蛋白折叠或稳定性?
- 细胞状态变化是否伴随全蛋白质组构象改变?
- 不同疾病样本中是否存在结构状态差异?
LiP-MS 的吸引力在于,它可以做得相对全局,不一定需要先知道靶点。2025 年底发表、2026 年刊出的 Journal of Proteome Research 教程综述将 LiP-MS 描述为一种 hypothesis-free 的药物靶点发现方法;它通过检测药物诱导的蛋白构象改变,并与高通量质谱结合,实现不依赖化学修饰的小分子靶点识别。[6]
这对药物研究很重要。
传统靶点发现常常依赖亲和纯化、探针标记或已知靶点假设。LiP-MS 的优势是:即使没有给小分子加标签,也有机会通过蛋白结构状态变化找到候选靶点。
当然,LiP-MS 也不是魔法。它检测的是构象或可及性变化,不等于所有变化都来自直接结合。一个药物影响通路后,也可能引起下游蛋白构象变化。所以 LiP-MS 产生的候选靶点,通常还需要用 CETSA、TPP、突变验证、体外结合实验或功能实验进一步确认。
LiP-MS 很适合发现线索,但机制结论还需要多方法验证。
六、Native MS:直接看完整复合物和分子机器
常规 bottom-up proteomics 通常会把蛋白酶切成肽段。这样做灵敏、高通量,但也会丢失完整复合物的信息。
Native MS 则走另一条路:尽量保持蛋白或蛋白复合物的非共价组装状态,把完整复合物送入质谱分析。
它可以回答:
- 一个复合物有多少个亚基?
- 亚基组成是什么?
- 化学计量是多少?
- 是否存在不同装配状态?
- 配体、金属离子或修饰是否改变复合物?
- 复合物是否存在不同 proteoform 组合?
早在 2008 年,Nature Methods 的 Perspective 就把 native MS 描述为连接 interactomics 和 structural biology 的桥梁,因为它可以高灵敏地研究完整蛋白复合物,并提供传统互作组学难以得到的复合物组成、结构和动态信息。[7]
近几年,native MS 又和 top-down proteomics 结合,进一步进入完整 proteoform 和复合物层面。2024 年 Nature Methods 的 native top-down 社区研究聚焦 native proteoforms 及其复合物,说明该领域正在推动跨实验室标准化和方法评估。[8]
这个方向和第六篇的 proteoform 主题密切相关。
第六篇讲过:同一个蛋白名下面可能有不同修饰、剪接、突变和加工形式。Native top-down MS 进一步追问:
- 这些 proteoform 是否存在于同一个复合物里?
- 它们是否改变复合物组装?
- 一个复合物是否由不同 proteoform 组合构成?
- 这些组合是否与疾病或药物响应有关?
所以,native MS 的价值不是“多鉴定几个蛋白”,而是直接观察蛋白机器的完整状态。
七、AP-MS 和 DIP-MS:从“互作名单”到“复合物版本”
蛋白质并不是单独工作的。
很多生命过程依赖蛋白复合物:转录、翻译、染色质重塑、DNA 修复、蛋白折叠、信号转导、囊泡运输、免疫识别。
AP-MS,也就是 affinity purification mass spectrometry,是研究蛋白互作的经典方法。它通常选择一个 bait protein,把它和结合的蛋白一起富集下来,再用质谱鉴定互作蛋白。
AP-MS 很强,但也有一个问题:
一次 AP-MS 得到的常常是一组“互作名单”,不一定能分清这些蛋白是否属于同一个复合物。
比如,一个 bait protein 可能参与多个不同复合物。AP-MS 把它们一起拉下来之后,我们可能知道有哪些蛋白出现,却不知道它们分别属于哪个复合物版本。
DIP-MS 就是为了解决这类问题而出现的代表方法。
2024 年 Nature Methods 发表的 DIP-MS 将 AP、blue-native-PAGE 分离、DIA-MS 和深度学习信号处理结合起来,用于在单次实验中解析共享同一 bait protein 的不同复合物 isoform。该研究在 prefoldin 相关复合物中解析了 holo-complex、subcomplex、complex–complex interaction 以及带有新亚基的复合物版本。[9]
这类方法的意义在于:
蛋白互作组学不再只是“谁和谁可能有关”,而是开始进入“它们如何组成不同复合物版本”。
这对细胞状态研究非常重要。
同一个核心复合物,在不同细胞类型、疾病状态或药物处理下,可能换掉某些亚基,加入新的调控因子,或者形成不同装配状态。DIP-MS 这类方法让我们可以更细地解析这种“复合物版本差异”。
所以,蛋白质组学正在从 interactome 走向 complexome。
八、Proximity labeling:捕捉活细胞里的邻近关系
AP-MS 更适合相对稳定的复合物,但很多细胞内互作是短暂的、弱的、依赖环境的。
比如:
- 膜接触位点;
- 细胞器邻近区域;
- 转录因子瞬时互作;
- 信号转导复合物;
- 蛋白与 RNA 或 DNA 的短暂接触;
- 某个蛋白在特定亚细胞区域的“邻居”。
这时候,proximity labeling 就很有价值。
Proximity labeling 的基本思路是:把一个能够催化标记反应的酶融合到目标蛋白或目标区域上,让它在活细胞中给附近分子加上可富集标签,比如生物素。随后用链霉亲和素富集被标记蛋白,再用质谱鉴定。
常见系统包括 BioID、APEX、TurboID、miniTurbo、split-TurboID 等。
Nature Methods 2021 年综述指出,proximity labeling 可以通过与 bait protein 融合的酶,在活细胞或生物体中标记邻近分子,再通过质谱或测序识别蛋白–蛋白、蛋白–RNA 和蛋白–DNA 相互作用。[10]
TurboID 是这一领域的重要升级。Nature Protocols 2020 年文章介绍,TurboID 是通过定向进化得到的高活性生物素连接酶,相比早期 BioID 具有更高活性,可用于哺乳动物细胞中蛋白互作和亚细胞蛋白质组 mapping;split-TurboID 还可以通过两个无活性片段重构来提高特异性。[11]
Proximity labeling 的优势是:
- 它可以在活细胞中发生;
- 它能捕捉弱互作和瞬时邻近;
- 它适合研究细胞器、膜接触、局部微环境和空间邻域;
- 它不一定要求互作在裂解和纯化过程中保持稳定。
但它也有局限。
它标记的是“邻近”,不一定等于直接接触。不同酶的标记半径和时间尺度不同。过表达融合蛋白可能改变定位或互作。生物素富集和背景控制非常关键。
所以,proximity labeling 最适合回答:
谁曾经在这个蛋白或区域附近出现?
而不是直接等同于:
谁和这个蛋白形成了稳定复合物?
这一点在文章里一定要讲清楚。
九、TPP 和 CETSA:药物是否真的打到了靶点?
药物研发中有一个非常现实的问题:
- 小分子加到细胞里之后,它真的进入细胞了吗?
- 它真的结合了预期靶点吗?
- 它有没有结合其他蛋白?
- 它在组织或血液样本中是否仍然有效?
- 它引起的表型是直接靶点作用,还是下游效应?
CETSA 和 TPP 就是为了解决这类问题的重要方法。
CETSA,全称 cellular thermal shift assay,基于一个简单但强大的原理:蛋白结合配体后,热稳定性可能改变。CETSA 可以在细胞或组织环境中检测药物对目标蛋白的结合。2014 年 Nature Protocols 文章介绍了 CETSA 用于评估细胞内药物靶点相互作用,并以 p38α 和 ERK1/2 等人类激酶为例说明其应用。[12]
TPP,也就是 thermal proteome profiling,可以看作是 CETSA 的蛋白质组学扩展。它用定量质谱在全蛋白质组范围内检测热稳定性变化,从而发现药物靶点和下游影响。Proteome Science 的综述指出,TPP 可用于 living cells 中无偏寻找药物靶点,不需要给化合物加标签,其基本原理是蛋白与配体结合后对热诱导展开更稳定。[13]
2014 年 Science 论文“Tracking cancer drugs in living cells by thermal profiling of the proteome”是这一方向的重要里程碑,它展示了用蛋白质组热稳定性变化追踪癌症药物在活细胞中的作用。[14] 2019 年 Nature Biotechnology 的 tissue-TPP 进一步把热稳定性 profiling 扩展到组织和全血样本,用于检测小分子药物在动物组织和血液中的靶点和脱靶作用。[15]
TPP/CETSA 的价值在于,它把药物作用从“推测”变成了可以直接测量的 target engagement。
但它也有局限。
不是所有配体结合都会显著改变热稳定性。热稳定性变化也可能来自蛋白复合物、下游状态或环境变化。膜蛋白和低丰度蛋白可能更难覆盖。不同温度曲线、样本处理和统计模型会影响结果。
因此,TPP/CETSA 很适合作为药物靶点验证和候选筛选工具,但最好与 LiP-MS、photoaffinity labeling、功能实验、遗传扰动和结构验证结合使用。
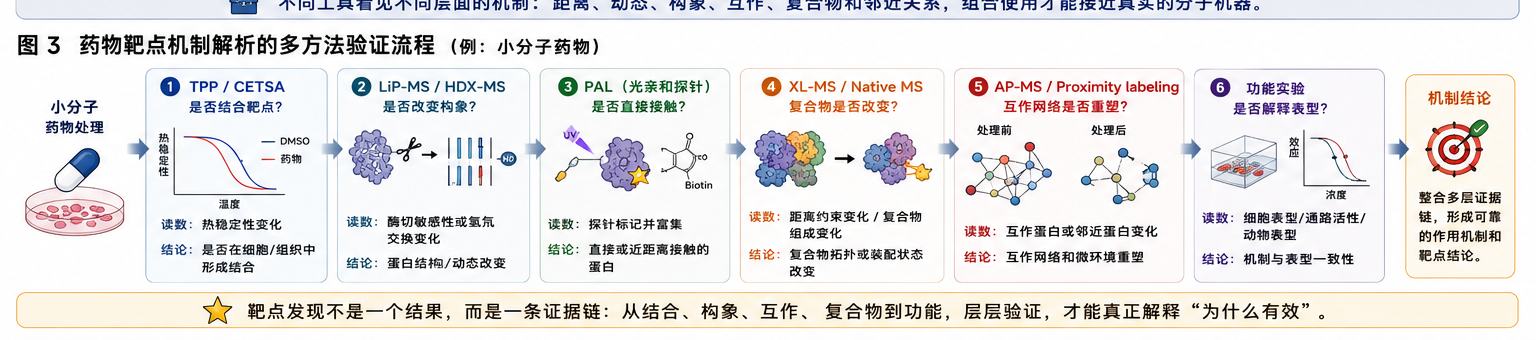
图 3|药物靶点机制解析的多方法验证流程
靶点发现不是一个结果,而是一条证据链。
十、Photoaffinity labeling:给小分子和靶蛋白拍一张“接触照片”
除了热稳定性和构象变化,还有一种更直接的化学生物学路线:
把小分子改造成可以被光激活的探针,让它在接触靶蛋白时形成共价连接。
这就是 photoaffinity labeling,简称 PAL。
PAL 的基本逻辑是:在小分子上引入光反应基团。小分子与蛋白接触后,用特定波长光激活,产生高反应性中间体,把附近蛋白共价标记下来。随后通过富集和质谱识别靶蛋白,甚至定位结合区域。
2024 年 Nature Reviews Methods Primers 的 PAL Primer 指出,photoaffinity labeling 是少数能够在 native biological environments 中直接绘制小分子–蛋白相互作用的方法之一;近年来,它与强大的质谱蛋白质组学结合,显著提升了全局尺度解析小分子作用靶点的能力。[18]
PAL 的优势是直接、可富集、适合靶点发现和结合位点研究。
但它也需要小分子可改造。探针设计可能影响小分子活性,光交联效率和背景标记也需要严格控制。
如果说 TPP 和 LiP-MS 更偏“状态变化读数”,PAL 则更像是:
把小分子和靶蛋白的接触瞬间固定下来。
这类方法在药物靶点发现、天然产物机制、共价 / 非共价小分子研究中都很有价值。
十一、这些方法不是互相替代,而是互相验证
写到这里,工具箱已经很丰富了。
- XL-MS 看距离约束;
- HDX-MS 看构象动态;
- LiP-MS 看蛋白酶切敏感性变化;
- Native MS 看完整复合物;
- AP-MS / DIP-MS 看互作和复合物版本;
- Proximity labeling 看活细胞邻近关系;
- TPP / CETSA 看药物靶点结合和热稳定性变化;
- PAL 看小分子与蛋白的直接接触。
这些方法并不是谁取代谁。
它们更像是在从不同角度观察同一个机制。
举个例子,一个新药处理肿瘤细胞后,你怀疑它作用于某个蛋白复合物,可以这样组合:
| 证据类型 | 可用方法 | 关键问题 |
|---|---|---|
| 靶点 engagement | TPP / CETSA | 药物是否改变候选蛋白热稳定性? |
| 构象变化 | LiP-MS / HDX-MS | 候选蛋白是否发生结构状态变化? |
| 直接接触 | PAL | 小分子是否能直接标记该蛋白? |
| 复合物变化 | XL-MS / Native MS | 复合物拓扑或装配是否改变? |
| 网络重塑 | AP-MS / Proximity labeling | 互作伙伴和邻近网络是否改变? |
| 生物学解释 | 功能实验 | 这些变化是否解释细胞表型? |
这才是机制解析的真正逻辑:
单一方法给线索,多方法交叉验证形成机制。
十二、AI 时代,实验结构蛋白质组学反而更重要
AlphaFold 之后,一个常见疑问是:
既然 AI 已经能预测结构,为什么还需要 XL-MS、HDX-MS、native MS 这些实验方法?
答案是:更需要。
因为 AI 结构预测通常给出的是静态模型,而细胞里的蛋白是动态的。
蛋白会被修饰。蛋白会与配体结合。蛋白会形成复合物。蛋白会在不同细胞状态下换构象。蛋白会在膜、细胞器、相分离结构或拥挤环境中改变行为。蛋白可能有多个构象,而不是一个固定结构。
AlphaFold 等模型非常适合作为结构假说和建模起点,但要解释真实机制,仍然需要实验约束。2023 年 Nature Methods 关于 AlphaLink 的报道正是这个趋势的例子:通过把 XL-MS 实验约束注入 AlphaFold2 工作流,模型可以更好地反映溶液中的构象和动态互作。[17]
所以,AI 并没有让结构蛋白质组学过时。
恰恰相反,AI 让结构蛋白质组学变得更重要:实验数据可以验证、约束和修正模型;AI 模型也可以帮助解释复杂质谱约束。
未来更有价值的不是“纯预测结构”,而是:
AI 预测 + 质谱约束 + 细胞状态 + 功能验证。
十三、这一篇的核心结论:蛋白质组学正在从“测量平台”变成“机制平台”
如果用一句话总结第八篇:
蛋白质组学不只是在做清单,而是在成为机制解析平台。
常规蛋白质组学告诉我们:哪些蛋白变了。
修饰组学告诉我们:蛋白状态如何改变。
空间蛋白质组学告诉我们:这些变化发生在哪里。
结构蛋白质组学告诉我们:蛋白如何改变构象。
互作蛋白质组学告诉我们:蛋白和谁一起工作。
药物靶点蛋白质组学告诉我们:小分子是否真正击中了目标。
这一步很关键。
因为生命系统不是由孤立蛋白组成的,而是由动态结构、复合物、邻近关系、修饰状态和药物扰动共同构成的。
过去十年,蛋白质组学从“能不能测到更多蛋白”,走向“能不能量得更稳、测得更多样本、测得更小样本、保留空间信息”。现在,它正在继续向机制层面推进:
- 这个蛋白怎么变形?
- 这个复合物怎么组装?
- 这个药物怎么起效?
- 这个疾病状态背后的分子机器出了什么问题?
当蛋白质组学能够回答这些问题,它就不再只是生命科学中的“检测技术”,而是成为理解机制、发现靶点和解释疾病的核心工具。
下一篇,我们继续走向临床和人群尺度:
一滴血里的蛋白质组:大队列、疾病预测与药物发现。
参考文献线索
-
O’Reilly, F. J. & Rappsilber, J. Cross-linking mass spectrometry: methods and applications in structural, molecular and systems biology. Nature Structural & Molecular Biology (2018).
https://www.nature.com/articles/s41594-018-0147-0 -
Scout / proteome-wide XL-MS standards: recombinant protein standards and benchmarking for proteome-wide cross-linking mass spectrometry. Nature Methods (2024).
https://www.nature.com/articles/s41592-024-02478-1 -
In vivo XL-MS 综述:活细胞中解析蛋白构象动态和复杂调控网络。Current Opinion in Chemical Biology (2025).
https://www.sciencedirect.com/science/article/pii/S1367593125000626 -
Masson, G. R. et al. Recommendations for performing, interpreting and reporting hydrogen deuterium exchange mass spectrometry experiments. Nature Methods (2019).
https://www.nature.com/articles/s41592-019-0459-y -
HX-MS² / DIA-HDX:推动 HDX-MS 数据自动化分析。Nature Communications (2024).
https://www.nature.com/articles/s41467-024-46610-3 -
LiP-MS 教程综述:用于 hypothesis-free 药物靶点发现和构象变化检测。Journal of Proteome Research (2025/2026).
https://pubs.acs.org/doi/full/10.1021/acs.jproteome.5c00565 -
Sharon, M. & Robinson, C. V. The role of mass spectrometry in structure elucidation of dynamic protein complexes. Nature Methods (2008).
https://www.nature.com/articles/nmeth.1265 -
Native top-down community study:完整 proteoform 和复合物的 native top-down MS。Nature Methods (2024).
https://www.nature.com/articles/s41592-024-02279-6 -
DIP-MS:AP + BN-PAGE + DIA-MS + 深度学习,用于解析共享 bait 的复杂复合物 isoform。Nature Methods (2024).
https://www.nature.com/articles/s41592-024-02211-y -
Proximity labeling 综述:用于活细胞中蛋白–蛋白、蛋白–RNA、蛋白–DNA 互作 mapping。Nature Methods (2021).
https://www.nature.com/articles/s41592-020-01010-5 -
TurboID / split-TurboID Nature Protocols:用于哺乳动物细胞中的 proximity labeling。Nature Protocols (2020).
https://www.nature.com/articles/s41596-020-0399-0 -
CETSA protocol:用热稳定性变化解析细胞内药物靶点 engagement。Nature Protocols (2014).
https://www.nature.com/articles/nprot.2014.138 -
TPP 综述:用 thermal proteome profiling 无偏寻找药物靶点。Proteome Science (2017).
https://proteomesci.biomedcentral.com/articles/10.1186/s12953-017-0122-4 -
Savitski, M. M. et al. Tracking cancer drugs in living cells by thermal profiling of the proteome. Science (2014).
https://pubmed.ncbi.nlm.nih.gov/25278616/ -
Tissue-TPP / blood-TPP:在组织和全血中识别药物靶点和脱靶作用。Nature Biotechnology (2019).
https://www.nature.com/articles/s41587-019-0388-4 -
Jumper, J. et al. Highly accurate protein structure prediction with AlphaFold. Nature (2021).
https://www.nature.com/articles/s41586-021-03819-2 -
AlphaLink:将 cross-linking MS 约束整合进 AlphaFold2 结构预测。Nature Methods (2023).
https://www.nature.com/articles/s41592-023-01890-3 -
Photoaffinity labeling Primer:在 native biological environments 中直接绘制小分子–蛋白相互作用。Nature Reviews Methods Primers (2024).
https://www.nature.com/articles/s43586-024-00308-4