一滴血里的蛋白质组:大队列、疾病预测与药物发现
系列第九篇
前八篇,我们从质谱平台、DDA/DIA、高通量定量、低输入、修饰组学、空间蛋白质组学,一直讲到结构、互作和机制解析。
这一篇进入更接近临床转化的方向:血浆蛋白质组、大队列、pQTL、疾病预测和药物发现。
本文导读
前面八篇里,我们一直在讲技术能力如何提升。
- 质谱平台让蛋白质组学测得更快、更深;
- DIA 让定量更稳定;
- 高通量工作流让几百、几千个样本成为可能;
- 低输入和单细胞技术让珍贵样本也能被分析;
- 修饰组学和 proteoform 帮助我们理解蛋白状态;
- 空间蛋白质组学保留组织现场;
- 结构与互作蛋白质组学让机制解析更有证据链。
这些技术最终都会指向一个更大的问题:
蛋白质组学能不能真正走进人群、疾病和临床?
如果只在细胞系里测几个样本,蛋白质组学当然可以帮助我们理解机制。
如果能在患者组织里测空间蛋白质组,它可以帮助我们理解病理微环境。
但如果我们想预测疾病风险、发现生物标志物、验证药物靶点,甚至在真实人群中理解健康和疾病之间的转换,就需要另一个尺度:
大队列蛋白质组学。
血液是这一研究方向的重要样本类型。
一滴血里,可能包含来自免疫系统、代谢系统、肝脏、心血管、神经、肿瘤、炎症和衰老过程的大量蛋白信号。血液样本相对容易获得,也更接近临床检测场景。
这就是为什么,过去几年,血浆蛋白质组学突然成为蛋白质组学中最接近临床转化的一条主线。
这一篇,我们就讲:
一滴血里的蛋白质组,如何连接基因、疾病预测和药物发现。
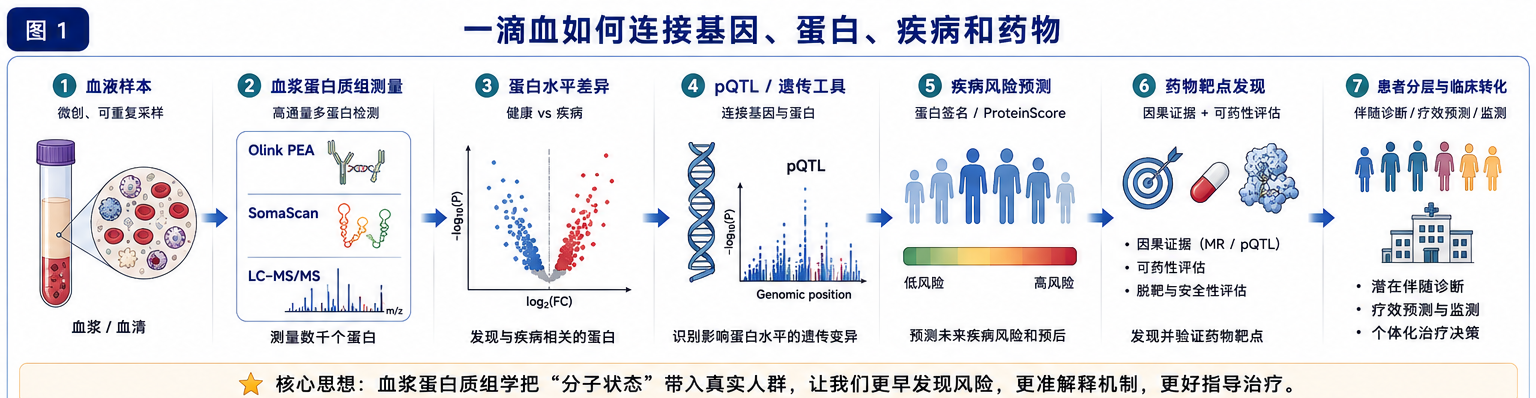
图 1|一滴血如何连接基因、蛋白、疾病和药物
血浆蛋白质组学把“分子状态”带入真实人群,让我们更早发现风险,更准解释机制,更好指导治疗。
一、为什么是血浆蛋白质组?
血液是临床医学中最常用的样本类型之一。
抽血方便、创伤小、可以反复采样,也可以和体检、随访、影像、基因组和电子病历连接起来。相比肿瘤组织、脑组织或器官活检,血液天然适合大规模人群研究。
血浆或血清中的蛋白,大致可以来自几类来源:
- 肝脏分泌的高丰度蛋白;
- 免疫细胞释放的炎症因子;
- 内分泌和代谢相关蛋白;
- 组织损伤后进入血液的蛋白;
- 肿瘤或病灶释放的蛋白;
- 细胞外囊泡、补体、凝血和基质相关蛋白。
这意味着,血浆蛋白质组像是身体状态的一面镜子。它不能告诉我们所有组织内部的细节,但它可以反映很多系统性变化。
这也是血浆蛋白质组特别适合做三件事:
- 发现疾病标志物;
- 预测未来疾病风险;
- 连接遗传变异、蛋白变化和药物靶点。
不过,血浆蛋白质组也非常难。
血浆中高丰度蛋白和低丰度蛋白之间的浓度跨度极大。白蛋白、免疫球蛋白等高丰度蛋白会占据大部分信号,而很多关键调控蛋白、细胞因子或肿瘤相关蛋白可能非常低丰度。Olink 也在技术说明中强调,血浆蛋白质组适合微创生物标志物研究,但其巨大动态范围是质谱分析面临的重要挑战;亲和平台则因高灵敏度和高通量,在复杂体液样本中越来越常用。1
所以,血浆蛋白质组学的核心矛盾是:
血液最适合临床,但也最难全面测量。
二、血浆蛋白质组学为什么突然能做大队列?
过去,血浆蛋白质组学很难大规模化。
原因很现实:质谱测血浆很难,深度覆盖需要复杂前处理;抗体检测通量有限;如果一个队列有几万人,单个蛋白一个一个测,成本和时间都不可承受。
变化来自两条路线的成熟。
第一条路线是高通量亲和检测平台,代表是 Olink 和 SomaScan。
Olink 的 PEA,也就是 Proximity Extension Assay,利用成对抗体识别目标蛋白,抗体上连接的 DNA 寡核苷酸在近距离时杂交延伸,形成可通过 qPCR 或 NGS 读取的 DNA 条形码。这个设计把蛋白识别和 DNA 扩增 / 测序读出连接起来,因此适合高通量、多重化检测。2
SomaScan 则是基于 aptamer 的高通量蛋白检测平台,使用被称为 SOMAmer 的慢解离速率修饰适配体来捕获目标蛋白。2022 年 Scientific Reports 对 7k SomaScan 平台的技术评估指出,该平台可同时测量 7,288 个人类蛋白,并覆盖从 femtomolar 到 micromolar 的广泛内源浓度范围。3
第二条路线是质谱血浆蛋白质组学的继续发展。
质谱的优势是更接近无偏检测,能看到肽段、蛋白异构体和部分 proteoform 信息,也更容易与前几篇讲过的 DIA、高通量、修饰组学和机制解析连接。但它在大队列血浆研究中仍面临动态范围、通量、成本和标准化挑战。
因此,现实中大队列血浆蛋白质组学目前主要由 Olink、SomaScan 等亲和平台推动,质谱更多承担补充验证、深度解析和机制层面的角色。
这两条路线不是互斥关系。
- 亲和平台适合大样本量、高灵敏度、预设蛋白 panel;
- 质谱适合更无偏、更结构化、更接近 proteoform 和机制解析。
未来真正成熟的临床蛋白质组学,很可能是两者互补。
三、UK Biobank:血浆蛋白质组学进入人群尺度的标志
如果要选一个血浆蛋白质组学进入大队列时代的标志性事件,UK Biobank Pharma Proteomics Project,简称 UKB-PPP,必须单独讲。
UKB-PPP 的目标,是在 UK Biobank 中进行大规模血浆蛋白质组 profiling,并把蛋白数据与基因组、表型、疾病随访和临床数据连接起来。UK Biobank 项目页写得很清楚:这个项目的主要科学目标是对 56,000 份 UK Biobank 血浆样本进行多重蛋白质组 profiling,用于发现新药靶点、验证已有靶点和疗法,并发现可能与治疗响应、患者分层或疾病分型相关的生物标志物。4
2023 年 Nature 论文进一步把这个资源推到前台。研究者在 54,219 名 UK Biobank 参与者中使用 Olink Explore 3072 平台测量 2,941 个血浆蛋白 analytes,覆盖 2,923 个 unique proteins,并进行大规模 pQTL 分析,识别出 14,287 个主要遗传关联,其中 81% 此前未被报道。5
这组数字很重要。
它说明血浆蛋白质组学不再只是几十个蛋白、几百个样本的小规模 biomarker 研究,而是开始具备类似基因组学的队列规模:
- 几万人;
- 几千个蛋白;
- 长期随访;
- 疾病结局;
- 基因型数据;
- 临床和生活方式信息。
这让蛋白质组学第一次真正站在“人群尺度”的位置上。
它不只是问:
某个疾病患者的血浆里哪些蛋白升高?
而是可以问:
在健康人群中,哪些蛋白预示未来疾病?哪些蛋白受遗传变异调控?哪些蛋白可能是药物靶点?哪些蛋白只是疾病过程的伴随信号?
这就是大队列血浆蛋白质组学的核心价值。
四、pQTL:把基因、蛋白和疾病连起来
第九篇里必须讲一个关键词:pQTL。
pQTL,全称 protein quantitative trait locus,意思是影响蛋白水平的遗传位点。
简单说,如果某个基因变异会影响血浆中某个蛋白的浓度,那么这个变异就可能是该蛋白的 pQTL。
为什么 pQTL 重要?
因为它给蛋白质组学加上了一层“遗传工具变量”。
单纯观察到某个蛋白和疾病相关,不代表这个蛋白是疾病原因。它可能是疾病后果,也可能是炎症、年龄、药物、生活方式或其他因素的伴随信号。
但如果某个遗传变异影响某个蛋白水平,而这个变异又与疾病风险相关,就可以用 Mendelian randomization、colocalization 等方法进一步判断:
- 这个蛋白是否可能参与疾病发生?
- 这个蛋白是否可能是药物靶点?
- 改变这个蛋白是否可能带来副作用?
- 某个疾病 GWAS 位点背后到底是哪一个蛋白在起作用?
这就是所谓的 proteogenomics,或者更具体地说,血浆蛋白质组 + 遗传学。
在 UKB-PPP 的 Nature 研究中,研究者不仅提供了大规模 pQTL 图谱,还展示了这些数据如何用于 drug discovery,例如扩展 PCSK9 等蛋白靶点的遗传代理效应,并帮助解析 COVID-19 易感位点中被扰动的具体基因和蛋白。6
deCODE 在冰岛人群中的研究也体现了同样的思路。2021 年 Nature Genetics 研究使用 SomaScan 在 35,559 名冰岛人中测量 4,907 个 aptamer 对应的血浆蛋白水平,识别出 18,084 个 pQTL,并把蛋白水平与 373 种疾病和其他表型联系起来;研究还提出 938 个编码潜在药物靶点的基因,这些基因的变异会影响可能的生物标志物水平。7
所以,大队列蛋白质组学的关键不是“测到了几千个蛋白”本身。
更关键的是:
这些蛋白可以和遗传变异、疾病结局和药物靶点放在同一张图里分析。
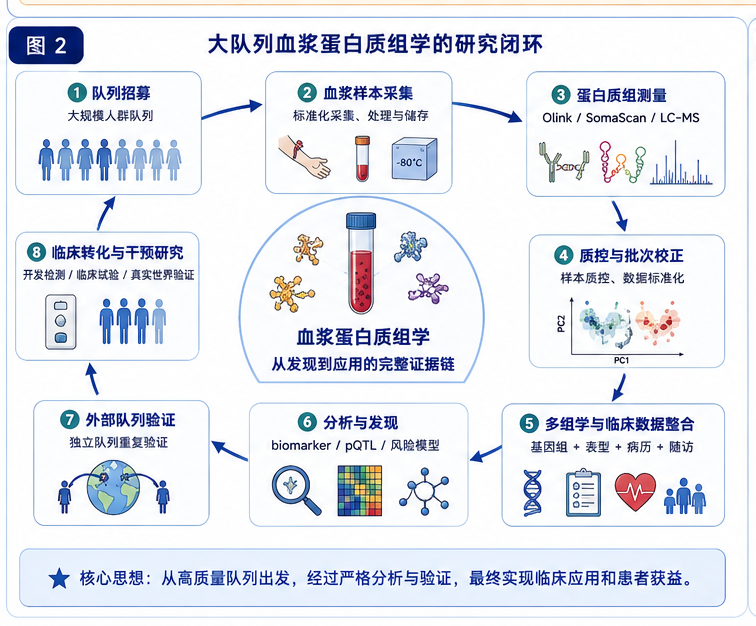
图 2|大队列血浆蛋白质组学的研究闭环
从队列招募到临床转化,中间不是一个发现结果,而是一整条证据链。
五、从 biomarker 到 drug target:蛋白质组学为什么适合药物发现?
药物研发最关心的不是“疾病相关分子有多少”,而是:
- 哪个分子值得作为靶点?
- 调高或调低它是否会改变疾病风险?
- 它是否有可药性?
- 它是否会带来副作用?
- 它是否和已有药物靶点重合?
- 它是否适合患者分层或疗效预测?
血浆蛋白质组学在药物发现中有几个优势。
第一,很多药物靶点本身就是蛋白。小分子、抗体、蛋白降解剂、细胞因子疗法,最终都在蛋白层面发挥作用。
第二,血浆蛋白可以反映系统性通路状态。炎症、免疫、补体、凝血、代谢、内分泌等通路都可以在血液中留下蛋白信号。
第三,pQTL 可以帮助区分因果和相关。观察性 biomarker 容易被混杂影响,而遗传工具可以为靶点优先级提供额外证据。
第四,大队列可以评估潜在副作用。如果某个蛋白的遗传升高不仅降低目标疾病风险,同时增加另一种疾病风险,药物研发就需要提前警惕。
2024 年 Nature Communications 的一项癌症研究很好地说明了这种逻辑。研究者调查 2,074 个循环蛋白与 9 种常见癌症风险之间的关系,使用 cis protein Mendelian randomization 和 colocalization 识别潜在治疗靶点,最终发现 40 个与常见癌症风险相关的蛋白,其中 18 个可映射到已有药物,15 个尚未处于临床研究中。8
这类研究的意义不是说“这些蛋白马上就是药物靶点”,而是给药物研发提供更系统的优先级排序:
- 哪些蛋白有遗传因果支持?
- 哪些蛋白已有药物可触及?
- 哪些蛋白可能适合 repurposing?
- 哪些蛋白可能是全新机会?
- 哪些蛋白调节可能带来不良影响?
这就是蛋白质组学和药物发现之间最重要的连接。
六、疾病预测:血浆蛋白质组能不能提前看见风险?
除了药物靶点,血浆蛋白质组学最容易引发公众关注的方向,是疾病预测。
因为血液样本天然让人想到体检和筛查。
如果一组蛋白能在疾病诊断前几年发生变化,那么它们就可能用于风险分层、早期预警或临床随访。
2024 年 Nature Medicine 的一项研究利用 UKB-PPP 数据,在 41,931 名参与者中整合约 3,000 个血浆蛋白和临床信息,为 218 种常见和罕见疾病建立 10 年发病风险预测模型。研究发现,包含少至 5–20 个蛋白的稀疏模型,在 67 种疾病上优于基础临床信息模型,并且在 52 种疾病上优于基础临床信息加 37 项临床检测数据的模型。9
这很重要,因为它说明血浆蛋白质组不一定需要把几千个蛋白全部搬进临床检测。
- 发现阶段可以测几千个蛋白;
- 转化阶段可以筛出少数核心蛋白;
- 临床阶段可能变成 5–20 个蛋白的小 panel。
这更接近真实临床应用。
另一项 Nature Communications 研究使用 52,006 名 UK Biobank 参与者的 1,461 个 Olink 血浆蛋白,训练 disease/mortality-specific proteomic risk score,也就是 ProRS,用于 45 类常见疾病和死亡风险分层;研究报告多个终点具有较高区分能力,其中 10 个终点 C-index 超过 0.80。10
这里要提醒一点:公众号不能把这些结果写成“血液蛋白已经可以临床预测所有疾病”。
更准确的说法是:
血浆蛋白质组正在证明自己可以为部分疾病提供比传统临床信息更强的风险分层能力,但距离广泛临床筛查仍需要外部验证、标准化、成本评估和临床试验。
这句话很重要。
因为生物标志物发现和临床检测之间,隔着很长一段路。
七、癌症早筛:最吸引人,也最需要谨慎
血浆蛋白质组学最容易被传播的案例,是癌症早期预警。
2024 年 Nature Communications 的一项 UK Biobank 研究分析了 1,463 个循环蛋白与 19 种癌症及 9 个癌症亚部位的风险关系,平均随访约 12 年。研究报告 618 个蛋白–癌症关联,其中 107 个关联在癌症诊断前 7 年以上仍然存在,182 个蛋白与诊断前 3 年内的癌症风险强相关。11
这类结果很容易让人兴奋:血液蛋白似乎能在癌症被诊断前多年出现信号。
但这里要非常谨慎。
第一,风险关联不等于可用于筛查。一个蛋白和癌症风险相关,不代表它能作为高特异性、高灵敏度的临床检测。
第二,早期信号可能混合了病因、早期病变和共病影响。有些蛋白可能参与癌症发生,有些可能是尚未诊断的早期肿瘤释放信号,有些可能只是炎症、衰老或组织损伤的标志。
第三,筛查需要考虑假阳性和后续医疗路径。癌症筛查不能只看 AUC 或 C-index,还要看阳性预测值、假阳性率、过度诊断、成本和患者心理负担。
第四,需要独立队列和前瞻性验证。UK Biobank 是极其宝贵的发现资源,但真正进入临床还需要不同人群、不同采样条件、不同平台和真实医疗场景的验证。
所以,这一节最适合这样收束:
癌症蛋白标志物的意义,不是马上推出“一滴血查癌症”,而是帮助我们理解癌症发生前身体已经出现了哪些蛋白层面的早期变化。
这既避免夸大,也保留了科学价值。
八、平台差异:Olink 和 SomaScan 测到的是同一个世界吗?
写大队列血浆蛋白质组学,不能只讲应用,还必须讲平台差异。
目前很多大型血浆蛋白质组研究基于 Olink 或 SomaScan。它们都能高通量测量数千个蛋白,但原理不同:
- Olink 使用双抗体 PEA;
- SomaScan 使用适配体 SOMAmer。
不同平台对同一蛋白的检测位点、结合方式、动态范围、背景、特异性和干扰因素可能不同。因此,同一个蛋白在不同平台上的读数不一定完全一致。
2023 年 Nature 的一项大规模平台比较研究分析 UKB-PPP 的 Olink Explore 3072 数据和冰岛人群 SomaScan v4 数据。研究发现,两平台之间总体相关性 modest;虽然两者检测到 cis pQTL 的 assay 绝对数量相近,Olink 为 2,101,SomaScan 为 2,120,但具有 cis pQTL 支持的 assay 比例在 Olink 中更高,为 72%,SomaScan 为 43%。研究还指出,相当多蛋白的遗传关联在两平台之间存在差异,这会影响基因、蛋白和疾病整合分析得出的结论。12
这段非常适合放在文章中提醒读者:
血浆蛋白质组学不是“测了就一定是真相”,平台本身也是生物学解释的一部分。
因此,在大队列蛋白质组学里,最好做到:
- 重要发现跨平台验证;
- 重要蛋白用 orthogonal assay 验证;
- 结合 pQTL 判断 assay 是否有遗传支持;
- 区分蛋白总量、蛋白片段、isoform 和结合表位;
- 在临床转化前建立绝对定量和标准化流程。
这也是血浆蛋白质组学从研究走向临床时必须跨过的一关。
九、血浆蛋白质组学和传统临床检验是什么关系?
很多人会问:
既然医院已经能测 CRP、肌酐、ALT、AST、肌钙蛋白、BNP、白蛋白、糖化血红蛋白,为什么还需要血浆蛋白质组学?
答案是:它们不是替代关系,而是发现和扩展关系。
传统临床检验是成熟、标准化、低成本、可解释的检测项目。
血浆蛋白质组学则是发现新标志物、新通路和新组合模型的工具。
在发现阶段,研究者可以一次测几千个蛋白,找出与疾病风险、疾病分型、药物响应相关的候选信号。
在转化阶段,候选信号可以被压缩成小 panel。
在临床阶段,这些 panel 需要变成绝对定量、可质控、可解释、可负担的检测。
2024 年 Nature Medicine 的疾病预测研究也体现了这种转化思路:它不是主张临床每次都测约 3,000 个蛋白,而是构建包含 5–20 个蛋白的稀疏模型,并与基础临床信息和临床 assay 进行比较。9
所以,大队列血浆蛋白质组学最合理的定位是:
用大规模、多蛋白发现,推动小规模、高价值临床检测。
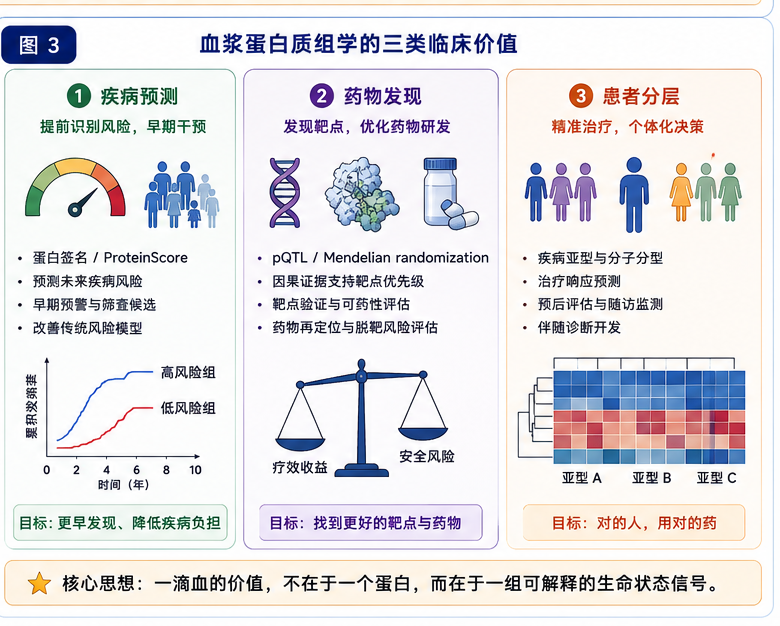
图 3|血浆蛋白质组学的三类临床价值
一滴血的价值,不在于一个蛋白,而在于一组可解释的生命状态信号。
十、从单点 biomarker 到蛋白网络:疾病不是一个蛋白说了算
早期 biomarker 研究常常希望找到一个“神奇蛋白”:
- 一个蛋白诊断一个疾病;
- 一个蛋白预测一种风险;
- 一个蛋白解释一个机制。
现实往往没有这么简单。
很多疾病是系统性状态改变。癌症、心血管疾病、糖尿病、神经退行性疾病、慢性炎症、自身免疫病,都可能牵涉多个组织、多个通路和多个时间阶段。
血浆蛋白质组学的优势正在于,它可以同时观察多个蛋白,形成“蛋白签名”。
这类签名可以有不同类型:
- 疾病特异性蛋白;
- 多个疾病共享的炎症或衰老蛋白;
- 器官来源相关蛋白;
- 药物靶点相关蛋白;
- 风险预测 protein score;
- pQTL 支持的因果候选蛋白。
2024 年 Nature Aging 的 UK Biobank 研究分析了 47,600 名参与者中 1,468 个 Olink 蛋白与 23 种年龄相关疾病和死亡的关系,报告 3,209 个蛋白–结局关联,并开发了 protein-based scores;其中 6 个 ProteinScores 在 10 年疾病发病预测中,超过了年龄、性别以及包含生活方式、临床生物标志物和身体测量指标的综合模型。13
这类研究说明,未来的临床蛋白质组学可能不是“一个蛋白对应一个疾病”,而是:
多个蛋白共同构成一种生命状态读数。
这和我们第一篇的主题正好呼应:从“测到蛋白”,走向“读懂生命状态”。
十一、血浆蛋白质组学目前还有哪些挑战?
这一篇必须强调,血浆蛋白质组学离真正临床应用还有挑战。
1. 动态范围和覆盖深度
血浆蛋白浓度跨度极大。高丰度蛋白会遮盖低丰度信号。亲和平台可以提高灵敏度,但受限于预设靶标和试剂质量;质谱更无偏,但在血浆中深度、通量和成本仍然需要平衡。
2. 平台差异和 assay specificity
Olink、SomaScan 和质谱测到的并不总是同一种“蛋白实体”。同一蛋白可能有不同 isoform、片段、翻译后修饰、复合物状态或结合表位。2023 年 Nature 的平台比较研究提醒我们,不同平台的蛋白读数和遗传关联可能存在显著差异,因此解释结果时不能忽略平台本身。12
3. 相关不等于因果
蛋白和疾病相关,不代表蛋白导致疾病。pQTL、Mendelian randomization 和 colocalization 可以提供因果线索,但仍然需要功能实验、药理学验证和临床研究支持。
4. 人群代表性不足
很多大队列主要来自欧洲 ancestry 人群。UKB-PPP 已经包括非欧洲 ancestry 的 pQTL 分析,但全球人群多样性仍然不足。疾病风险模型如果只在一个人群中训练,未必能直接推广到其他人群。
5. 临床转化门槛高
真正进入临床,需要绝对定量、标准化质控、批次可比性、参考区间、临床获益评估、成本效益分析和监管审批。一个 biomarker 论文发表,不等于一个临床检测已经可用。
6. 预测带来的伦理和医疗路径问题
如果一个血液蛋白模型告诉某人未来 10 年某病风险升高,下一步该怎么办?是否有干预方案?假阳性如何处理?患者心理负担如何评估?这些都不是纯技术问题。
所以,第九篇的态度应该是:
血浆蛋白质组学非常接近临床,但不能把发现研究直接包装成临床检测。
十二、这一篇的核心结论:血浆蛋白质组学正在把蛋白质组学推向人群医学
如果用一句话总结第九篇:
血浆蛋白质组学让蛋白质组学从实验室和组织样本,走向真实人群、疾病预测和药物发现。
它的意义不只是“抽一管血测几千个蛋白”。
更重要的是,它把几层信息连接在了一起:
- 基因变异;
- 血浆蛋白水平;
- 生活方式和环境;
- 临床指标;
- 疾病结局;
- 药物靶点;
- 风险预测;
- 患者分层。
UKB-PPP、deCODE、Olink、SomaScan、质谱血浆蛋白质组学等共同推动了这个方向。几万人规模的蛋白质组数据,让我们第一次可以系统地问:
- 哪些蛋白反映当前健康状态?
- 哪些蛋白预示未来疾病?
- 哪些蛋白可能参与疾病因果机制?
- 哪些蛋白可以作为药物靶点?
- 哪些蛋白签名可以帮助患者分层?
- 哪些发现能真正转化成临床检测?
这正是蛋白质组学走向精准医学的关键一步。
但它也提醒我们:临床转化不能只靠漂亮的相关性图谱。真正有价值的血浆蛋白质组学,需要平台验证、机制支持、外部队列、临床试验和真实医疗场景检验。
过去十年,蛋白质组学从“测到蛋白”,走向“稳定定量”“单细胞”“空间”“修饰”“机制”。现在,它又走向了人群和临床。
下一篇,也是这个系列的收官篇,我们将回到全局:
蛋白质组学的下一站:AI、多组学和临床标准化。
参考文献线索
Footnotes
-
Olink. Mass spectrometry and plasma proteomics applications. https://olink.com/application/application-mass-spec ↩
-
Olink. Olink technology: Proximity Extension Assay. https://olink.com/technology ↩
-
SomaLogic / Scientific Reports, 2022. Technical assessment of the 7k SomaScan platform. https://www.nature.com/articles/s41598-022-22116-0 ↩
-
UK Biobank. Large-scale proteomic profiling to facilitate genetics-guided drug discovery and precision medicine: the UK Biobank Pharma Proteomics Project. https://www.ukbiobank.ac.uk/projects/large-scale-proteomic-profiling-to-facilitate-genetics-guided-drug-discovery-and-precision-medicine-the-uk-biobank-pharma-proteomics-project-ukb-ppp/ ↩
-
Sun et al., 2023, Nature. Plasma proteomic associations with genetics and health in the UK Biobank. https://www.nature.com/articles/s41586-023-06592-6 ↩
-
UK Biobank publication page. Plasma proteomic associations with genetics and health in the UK Biobank. https://www.ukbiobank.ac.uk/publications/plasma-proteomic-associations-with-genetics-and-health-in-the-uk-biobank/ ↩
-
Ferkingstad et al., 2021, Nature Genetics. Large-scale integration of the plasma proteome with genetics and disease. https://www.nature.com/articles/s41588-021-00978-w ↩
-
Nature Communications, 2024. Identifying therapeutic targets for cancer among circulating proteins using Mendelian randomization and colocalization. https://www.nature.com/articles/s41467-024-46834-3 ↩
-
Nature Medicine, 2024. Plasma proteomic risk scores for 218 diseases in the UK Biobank. https://www.nature.com/articles/s41591-024-03142-z ↩ ↩2
-
Gadd et al., 2023, Nature Communications. Blood protein assessment of leading incident diseases and mortality in the UK Biobank. https://www.nature.com/articles/s41467-023-43575-7 ↩
-
Nature Communications, 2024. Identifying circulating protein biomarkers of cancer risk using observational and genetic analyses. https://www.nature.com/articles/s41467-024-48017-6 ↩
-
Sun et al., 2023, Nature. Genetic regulation and disease relevance of plasma proteins measured by Olink and SomaScan. https://www.nature.com/articles/s41586-023-06563-x ↩ ↩2
-
Nature Aging, 2024. Proteomic signatures of age-related disease and mortality in the UK Biobank. https://www.nature.com/articles/s43587-024-00655-7 ↩