一次测几十、几百、几千个样本:蛋白质组学如何进入高通量定量时代
导读
前三篇里,我们讲了蛋白质组学的十年跃迁,讲了质谱平台这台“发动机”为什么变快,也讲了 DDA 到 DIA 的采集策略变化。
这一篇继续往前走:当蛋白质组学真的要处理几十、几百、几千个样本时,定量策略、批次控制、实验设计和质控体系会发生什么变化?
01|高通量不只是“测得快”,而是让研究问题变大
如果一个技术只能测几个样本,它可以做机制探索;
如果它能稳定测几十个样本,它可以做系统比较;
如果它能测几百、几千个样本,它才真正进入队列研究、药物筛选和临床转化。
这就是高通量定量蛋白质组学的意义。
蛋白质组学过去很长时间被认为“很强,但不够快”。它可以在单个样本里看到很多蛋白,可以做出漂亮的深度图谱;但当研究问题变成大规模比较时,挑战立刻出现:样本太多,机时太长,批次效应太明显,缺失值太多,成本太高,数据分析也越来越复杂。
过去十年,高通量定量蛋白质组学正是在解决这些问题。
它不只是把样本数量做大,而是在回答一个更关键的问题:
怎样让成百上千个蛋白质组数据,仍然可比较、可统计、可解释?
在低通量时代,研究者常常问:
- 处理组和对照组有什么差异?
- 这个药物是否影响某条通路?
- 这个细胞模型里有哪些蛋白改变?
到了高通量时代,问题会变成:
- 不同患者之间的蛋白状态能不能分型?
- 一百种药物处理后的蛋白响应能不能形成指纹?
- 疾病进展过程中蛋白网络如何动态变化?
- 同一个生物标志物在不同队列、不同中心、不同批次里是否稳定?
- 蛋白质组数据能不能支持机器学习和临床预测?
这类问题靠三五个样本很难回答。它们需要大量样本,需要重复,需要时间序列,需要多条件矩阵,也需要严格的统计设计。
所以,高通量定量的核心不是“跑得快”,而是让蛋白质组学从个案观察走向群体比较。
02|为什么蛋白质组学一开始很难高通量?
蛋白质组学进入高通量时代,比基因组学和转录组学慢得多。
原因很简单:蛋白质组学的每一步都很难批量化。
-
样本制备难。
蛋白提取、还原、烷基化、酶切、脱盐、标记,每一步都可能引入损失和批次差异。 -
液相色谱慢。
传统深度蛋白质组学常常依赖长梯度 nano-LC,一个样本动辄 1 小时甚至更久。 -
质谱采集复杂。
样本越多,越要求仪器长时间稳定运行;稍微漂移,就会影响跨批次定量。 -
数据矩阵不完整。
尤其在 DDA 工作流中,不同样本中被采集到的肽段不完全一致,会产生大量 missing value。 -
数据分析压力大。
几百上千个 LC-MS 文件不仅数据量大,还要处理归一化、批次校正、缺失值、FDR、蛋白推断和统计建模。
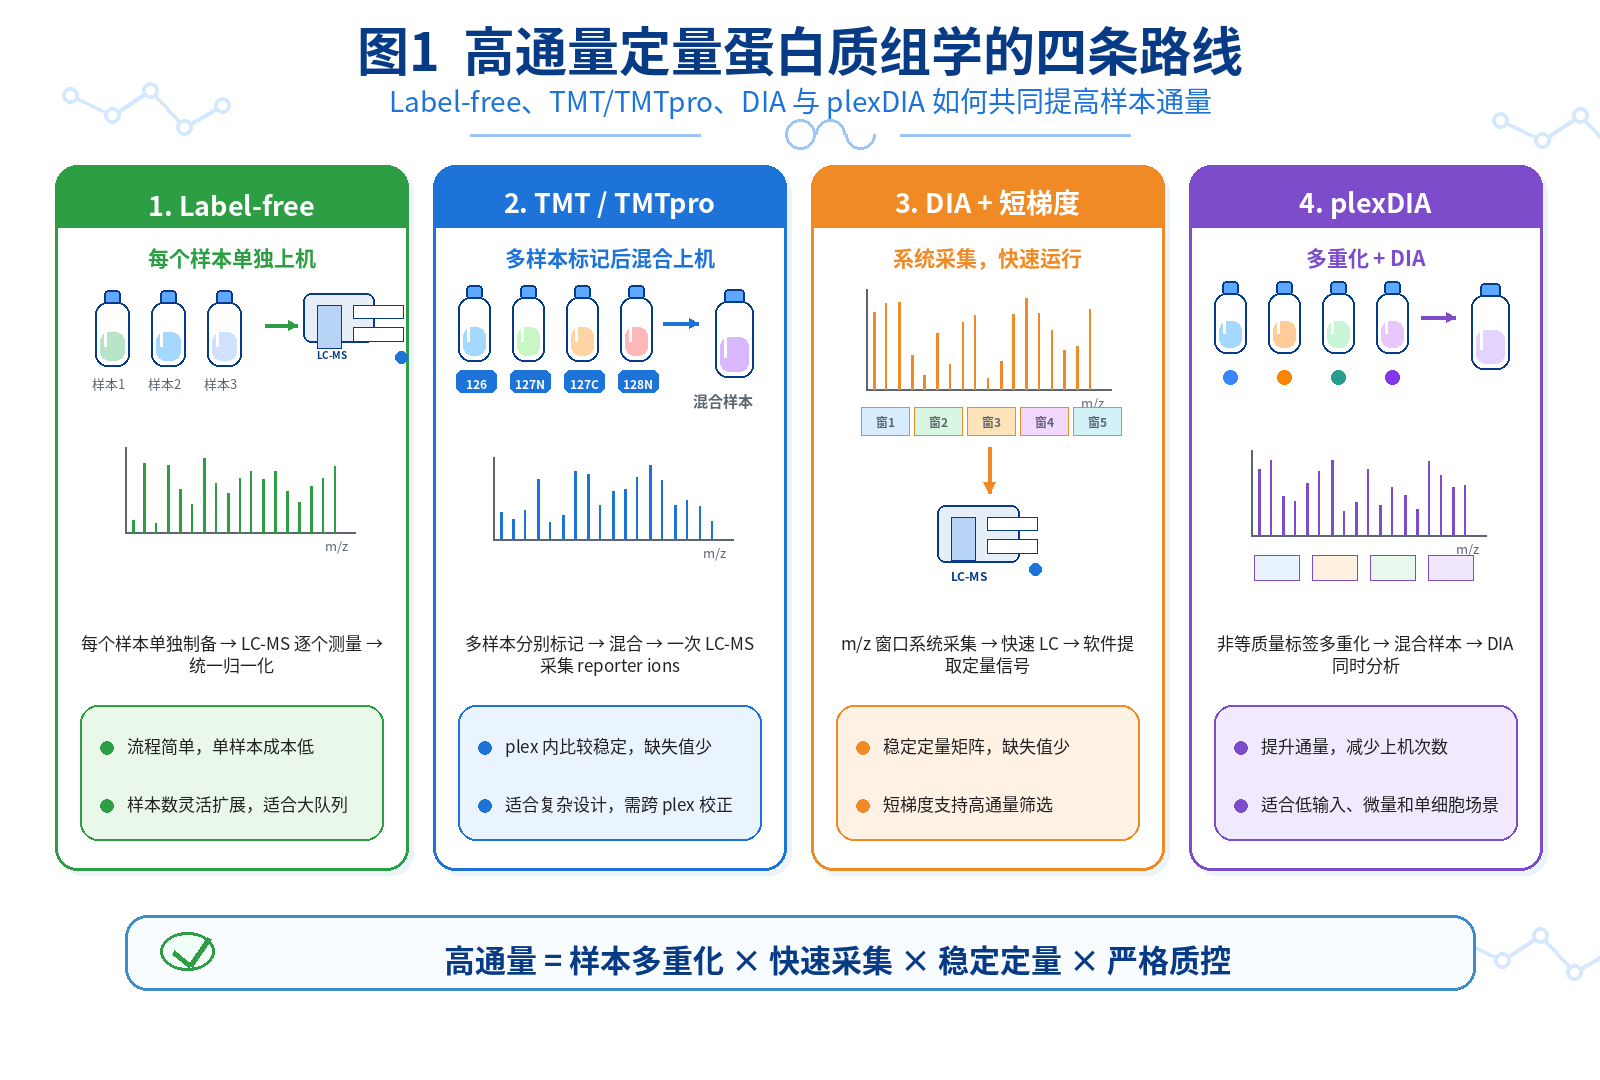
这也是为什么过去十年高通量蛋白质组学的发展,不是靠单一技术解决,而是由几条路线共同推动:
Label-free、TMT / TMTpro、DIA 高通量工作流、plexDIA、自动化样本制备和标准化质控。
03|第一条路线:Label-free,让大规模实验更灵活
Label-free quantification,简称 LFQ,也就是非标记定量,是最容易理解的一条路线。
它不需要给样本加同位素标签,也不需要把多个样本混在一起。每个样本单独制备、单独上机,然后根据肽段信号强度或谱图计数来做相对定量。
它的优势很明显:
- 流程相对简单;
- 成本较低;
- 样本数量扩展灵活;
- 不受标记通道数量限制;
- 适合大队列和常规比较。
MaxLFQ 是 label-free 定量成熟过程中的重要代表。2014 年,Cox、Mann 等提出 MaxLFQ,通过 delayed normalization 和 maximal peptide ratio extraction 进行蛋白丰度估计,目标是让非标记定量在大规模蛋白质组实验中更准确、更稳健;该方法已整合在 MaxQuant 中,并可处理 500 个以上样本规模的数据。[1]
但 label-free 也有明显短板。
因为每个样本是单独上机测量,所以跨样本比较非常依赖仪器稳定性、色谱保留时间稳定性、归一化方法和批次校正。样本越多,运行时间越长,漂移和批次效应越难避免。
2016 年的多中心 benchmark 研究比较了多种 label-free DIA / SWATH 数据分析工具,指出准确、稳定的 label-free 定量不仅取决于质谱仪和采集方法,也高度依赖数据分析软件;该研究还提出 LFQbench 用于评估定量精度和准确性。[2]
所以,label-free 的本质优势是灵活和可扩展,但前提是整套 LC-MS 和分析流程足够稳定。
Label-free 适合样本数不断扩大的研究,但它把压力放在仪器稳定性、运行顺序、归一化和批次控制上。
04|第二条路线:TMT / TMTpro,把多个样本“绑在一起”测
如果说 label-free 是“每个样本单独跑”,那么 TMT 的思路就是“多个样本先合并,再一起跑”。
TMT,全称 tandem mass tag,是一种等obaric labeling,也就是等质量标记技术。不同样本被不同标签标记后,在 MS1 层面看起来质量相同,可以混合在一起上机;到 MS/MS 碎裂时,标签释放出不同 reporter ion,用这些 reporter ion 的强度来比较不同样本的相对丰度。
这个设计非常巧妙。
因为多个样本被混在同一次 LC-MS 运行中,它们经历同样的色谱、同样的离子化、同样的碎裂和同样的检测环境。这样可以减少样本之间的技术波动,并且在同一个 plex 内几乎不会出现某个样本“没有测到”的情况。
TMTpro 的出现进一步扩展了这种多重化能力。2020 年 Nature Methods 论文介绍了 TMTpro 16-plex 试剂,展示了 16 个样本同时进行蛋白质组表达测量的能力,并在示例数据中实现了复杂实验设计下的蛋白质组定量。[3] 2021 年,TMTpro-18plex 进一步扩展到 18 个通道,使“6 个条件 × 3 个生物学重复”这样的设计可以刚好放进一个 plex 中。[4]
这对复杂实验非常有吸引力。
比如:
- 6 个药物剂量 × 3 个重复;
- 4 个时间点 × 4 个处理组;
- 多个患者样本加一个 pooled reference channel;
- 蛋白组和磷酸化蛋白组联合分析;
- 热稳定性、药物靶点和细胞状态扰动实验。
TMT 的强项是实验设计紧凑、缺失值少、同批次比较稳定。
但 TMT 也有自己的问题,其中最经典的是 ratio compression,也就是比例压缩。
简单说,当目标肽段和其他背景离子被共同隔离、共同碎裂时,reporter ion 信号可能受到干扰,使真实差异被低估。2011 年 Nature Methods 论文系统展示了等obaric 标签定量中的 ratio distortion 问题,并指出 MS3 方法可以显著减少这种干扰。[5]
后来,SPS-MS3、real-time search MS3 等策略就是为了解决 TMT 定量准确性和覆盖深度之间的矛盾。
所以,TMT 的本质是:
用化学标记换取样本多重化和批次内一致性,但要处理 reporter ion 干扰、通道设计、成本和跨 plex 校正问题。
05|Label-free 和 TMT,不是谁取代谁
很多读者会直接问:到底该选 label-free 还是 TMT?
答案不是“谁更好”,而是“谁更适合你的问题”。
| 维度 | Label-free | TMT / TMTpro |
|---|---|---|
| 样本处理 | 每个样本单独跑 | 多个样本标记后混合跑 |
| 成本 | 单样本试剂成本较低 | 标记试剂成本较高 |
| 扩展性 | 样本数灵活扩展 | 受通道数限制,但每个 plex 内高效 |
| 缺失值 | 取决于采集和软件,DIA 后改善明显 | 同一 plex 内缺失值较少 |
| 批次控制 | 依赖 QC、归一化和运行稳定性 | plex 内较好,跨 plex 需要桥接样本 |
| 定量问题 | 色谱漂移、归一化、缺失值 | ratio compression、通道串扰、跨 plex 校正 |
| 适合场景 | 大队列、探索性比较、成本敏感项目 | 复杂实验设计、修饰组学、需要批次内强可比性的项目 |
可以粗略这样判断:
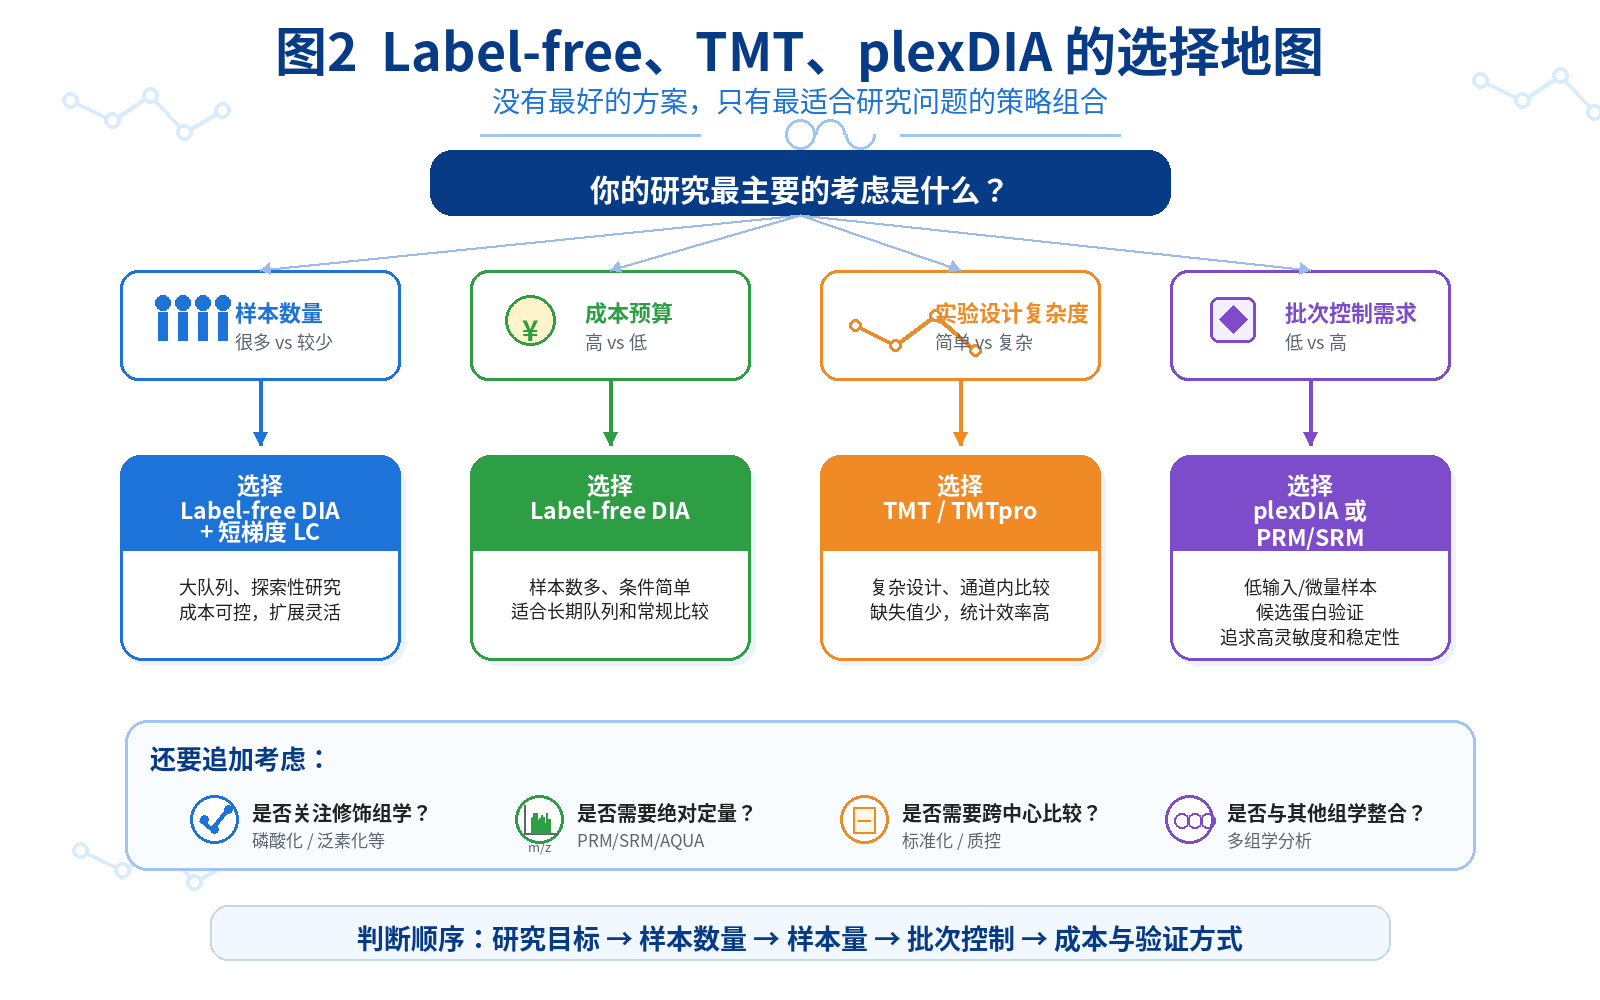
- 样本数量非常大、条件相对简单、成本敏感:label-free DIA 往往更合适。
- 条件复杂、重复设计紧凑、需要同批次比较:TMT / TMTpro 很有优势。
- 低输入、单细胞、样本量少但又想提高通量:plexDIA 是值得关注的新方向。
06|第三条路线:DIA + 短梯度,把 label-free 推向真正高通量
第三篇我们已经讲过,DIA 的优势在于系统性采集和稳定定量。
到了高通量场景,DIA 的优势会被进一步放大。
因为大队列研究最怕的不是单个样本少测几个蛋白,而是不同样本之间数据矩阵不一致。DIA 更容易产生完整、可比较的数据矩阵,因此非常适合 label-free 高通量定量。
过去几年,DIA 与短梯度 LC、高速质谱和新软件结合,推动了高通量蛋白质组学快速发展。
2021 年 Nature Biotechnology 的 Scanning SWATH 研究展示了一个代表性方向:通过连续移动的 precursor isolation window 和高流速短梯度色谱,提高超快速蛋白质组采集能力。该研究报告,在 0.5–5 分钟色谱梯度中,Scanning SWATH 相比常规 DIA 方法可提高约 70% 的前体识别数量,并支持每天数百个样本级别的高通量测量。[6]
2024 年的 narrow-window DIA / Orbitrap Astral 工作则展示了另一条路线:借助约 200 Hz 的并行 MS/MS 扫描和 2-Th 窄窗口,研究者在 5 分钟梯度中可定量约 7000 个人类蛋白组,在半小时梯度中可达到约 1 万个人类蛋白组,并报告每天 48 个深度人类蛋白质组或 100 多个酵母蛋白质组的能力。[7]
这说明,高通量 DIA 的核心不是简单缩短时间,而是在三个维度上同时优化:
- 色谱梯度更短,但峰形和重现性仍要足够好;
- 质谱扫描更快,但碎片信息仍要足够可靠;
- 算法更强,能够从复杂、压缩的时间窗口中提取稳定定量信号。
这条路线的意义非常大。
它让蛋白质组学开始接近转录组学式的大规模实验设计:更多样本、更多条件、更多时间点、更强统计能力。
07|第四条路线:plexDIA,把“样本多重化”和 DIA 合在一起
TMT 是样本多重化。
DIA 是系统性采集。
那能不能把两者结合起来?
plexDIA 就是这个方向的重要代表。
plexDIA 的核心思想是:使用非等obaric mass tags 对多个样本进行标记,使它们可以在同一次 DIA 运行中同时被分析。这样一来,通量提升来自两个方面:一方面 DIA 本身系统采集,另一方面多个样本被复用到同一次 LC-MS 运行中。
2022 年发表、2023 年正式成文的 Nature Biotechnology 论文介绍了 plexDIA 框架。研究显示,三重非等obaric 标签的 plexDIA 可以在不降低蛋白覆盖和定量准确性的情况下,以标签数量为倍数提升通量;在 1 小时 active gradient 中,每个三重标记组的样本可定量约 8000 个蛋白,并降低跨样本缺失数据;用于单细胞时,plexDIA 可在每个细胞约 5 分钟 active chromatography 的条件下定量约 1000 个蛋白。[8]
plexDIA 的重要性在于,它瞄准了一个过去很难兼顾的问题:
低输入样本需要灵敏度,高通量实验需要速度,而多重化 DIA 试图同时要这两件事。
它尤其适合微量样本、低输入蛋白质组学和单细胞蛋白质组学。虽然 plexDIA 目前还不是所有实验室的常规配置,但它代表了一个趋势:未来的高通量蛋白质组学不一定只靠“跑得更快”,也会靠“每次运行承载更多样本”。
08|高通量时代真正的难题:批次效应
当样本数从 10 个增加到 100 个,再增加到 1000 个,真正的敌人往往不是“测不到蛋白”,而是批次效应。
什么是批次效应?
- 样本不是同一天制备的;
- 不是同一批试剂标记的;
- 不是同一根色谱柱跑的;
- 不是同一次仪器维护前后测的;
- 不是同一个实验员处理的;
- 不是同一个 plex 或同一个队列批次里的。
这些差异如果没有控制好,就可能被误认为生物学差异。
比如,你看到 A 组和 B 组蛋白表达不同,但其实 A 组大多在周一测,B 组大多在周五测;或者疾病组在一个 TMT plex,健康组在另一个 TMT plex。这样的设计会让后续统计分析非常危险。
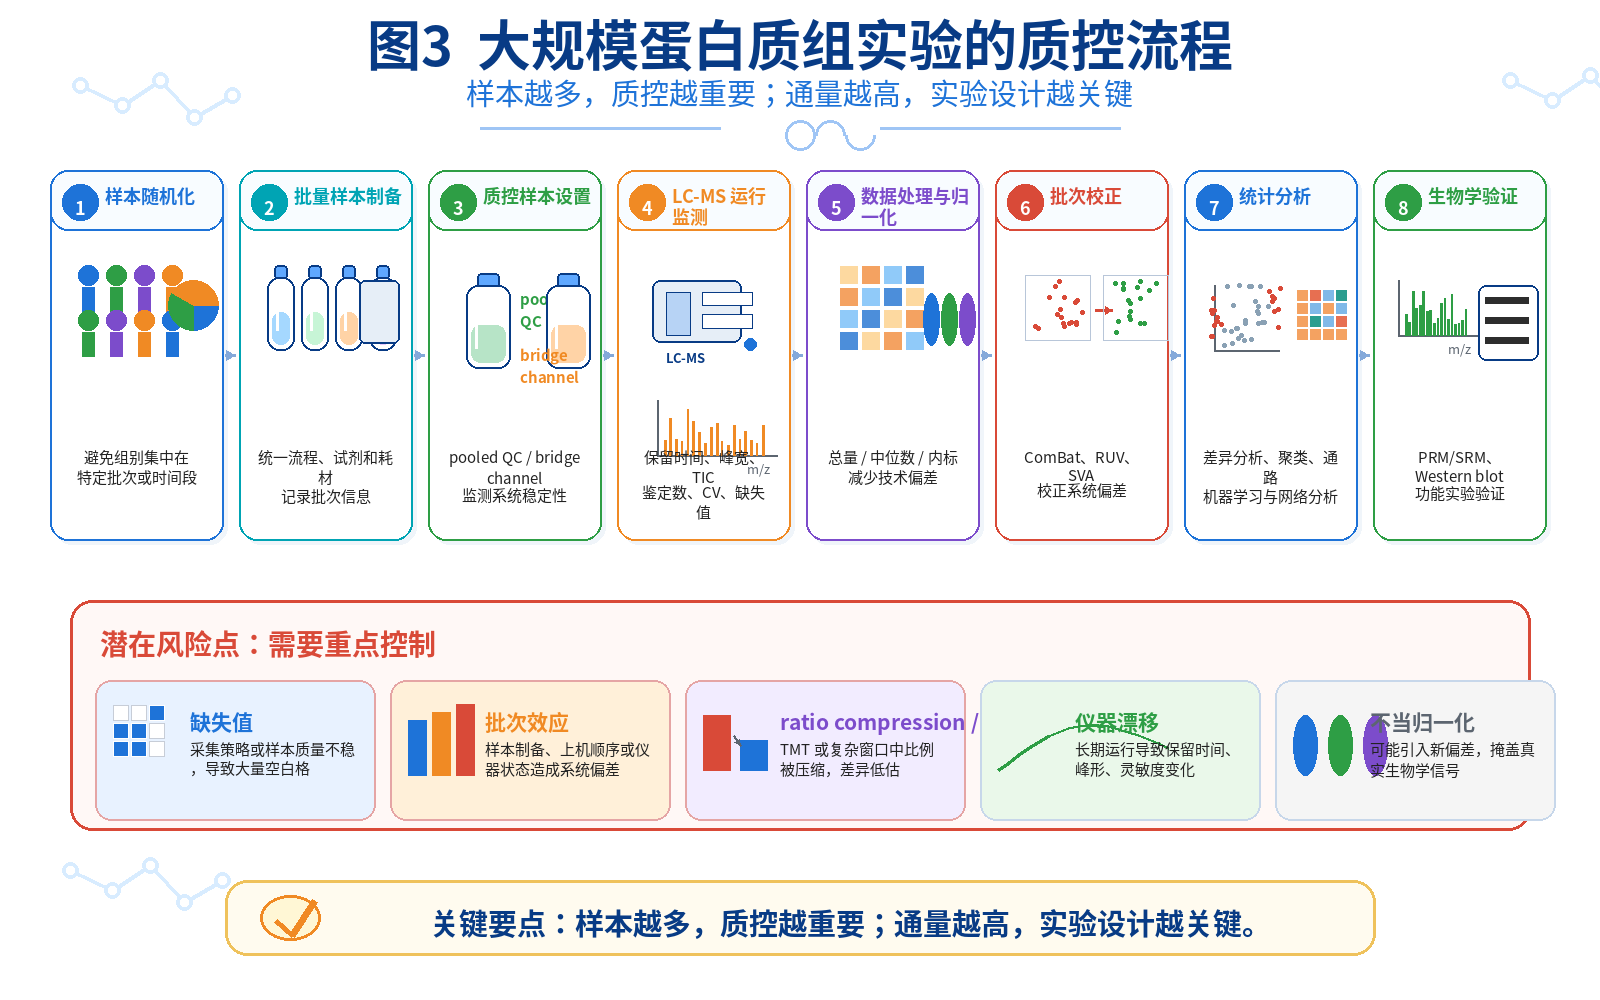
因此,高通量蛋白质组学必须从一开始就做实验设计。
常见策略包括:
- 样本随机化上机;
- 在每个批次中放入 pooled QC;
- TMT 中设置 bridge / reference channel;
- 不同组别均匀分布到不同 plex;
- 定期插入质量控制样本;
- 监测保留时间、峰宽、鉴定数、CV、缺失值比例;
- 在分析阶段进行归一化和批次校正。
2020 年 Nature Communications 的多中心研究展示了标准化和 harmonization 对大规模蛋白质组学的重要性。该研究在 11 个国际实验室中使用协调的 MS 平台和标准化采集程序,在 7 天、24/7 运行模式下评估了 HRMS1-DIA 工作流,强调 QC-benchmarked workflow 对跨中心临床样本蛋白质组数据生成的重要性。[9]
这说明,高通量蛋白质组学不是“把机器开起来连续跑”这么简单。
它更像是一个工程系统:样本、仪器、软件、统计和质控必须同时在线。
09|高通量定量蛋白质组学改变了哪些应用?
高通量定量带来的变化,可以从四类应用理解。
1. 药物扰动和机制筛选
过去研究一个药物机制,可能只做处理组和对照组。现在可以做多个药物、多个剂量、多个时间点,得到蛋白质组响应矩阵。
这种矩阵可以回答更复杂的问题:
- 药物是否真正击中靶点?
- 通路响应是早期还是晚期?
- 不同药物是否产生相似蛋白指纹?
- 耐药细胞的状态变化是什么?
- 药物组合是否重塑同一组蛋白网络?
TMT / TMTpro 很适合这类复杂实验设计,因为它可以把多个条件放进同一个 plex 中比较;短梯度 DIA 则适合大规模扰动筛选。
2. 疾病分型和临床队列
疾病不是单一状态。即便是同一种癌症,不同患者之间也可能有完全不同的蛋白质组状态。
高通量蛋白质组学使研究者可以在更大样本量中寻找疾病亚型、预后标志物和治疗响应模式。
这里 label-free DIA 的优势很明显:样本数可以灵活扩展,成本相对可控,适合长期队列。
3. 时间序列和动态生命过程
蛋白质组学过去常常做静态比较:处理前 vs 处理后。
但生命状态是动态的。细胞分化、药物响应、免疫激活、感染过程、代谢重塑都需要时间序列数据。
高通量让更多时间点成为可能,也让动态建模更可靠。
4. 多组学整合
当蛋白质组数据可以规模化,它就更容易和基因组、转录组、代谢组、表型数据整合。
这会改变蛋白质组学的位置:它不再只是单独的“蛋白清单”,而是多组学生命状态模型中的关键层。
10|但不要把高通量误解为“越快越好”
高通量蛋白质组学很诱人,但也很容易被误解。
最常见的误解是:样本数越多越好,梯度越短越好,蛋白数量越高越好。
其实不是。
如果研究目标是深度机制解析,短梯度可能不够。
如果关注低丰度蛋白或修饰组学,样本制备和富集比速度更重要。
如果实验设计不平衡,1000 个样本也可能产生错误结论。
如果批次效应没有控制,机器学习模型可能学到的是上机顺序,而不是疾病状态。
如果只追求蛋白数量,不关注定量精度和缺失值,后续分析会非常脆弱。
所以,高通量不是单纯追求“更多”,而是要在四件事之间找平衡:
深度、通量、定量准确性、实验成本。
不同场景应该选择不同策略。
| 研究目标 | 推荐策略 |
|---|---|
| 少量样本、追求深度机制 | 长梯度 label-free DDA / DIA 或 TMT 深度分级 |
| 中等样本、多条件比较 | TMT / TMTpro 或 DIA |
| 大队列、成本敏感 | label-free DIA + 严格 QC |
| 药物筛选、时间序列 | 短梯度 DIA / Scanning SWATH / 高通量 LFQ |
| 微量样本、低输入 | plexDIA、低输入 DIA、专门样本制备 |
| 修饰组学大规模比较 | TMT / TMTpro + 富集 + SPS-MS3,或 DIA 修饰组工作流 |
11|这一篇的核心结论
如果用一句话总结这一篇:
高通量定量蛋白质组学的真正价值,不是多测几个样本,而是让蛋白质组学拥有足够的统计力量去解释复杂生命状态。
Label-free 让样本扩展更灵活。
TMT / TMTpro 让复杂实验设计更紧凑。
DIA 让大样本定量矩阵更完整。
短梯度和高速平台让通量边界被推开。
plexDIA 把样本多重化和 DIA 结合,为低输入和单细胞场景提供新可能。
标准化质控则决定这些数据能不能真正用于临床和大队列。
蛋白质组学从“测得深”走向“测得多”,并不是一次简单的速度提升。
它意味着这个领域开始从少量样本的技术展示,走向真正的大规模生物学。
下一篇,我们继续往下走:
从一小块组织到一个细胞:低输入蛋白质组学的十年进化。
参考文献线索
- Cox J, Hein MY, Luber CA, Paron I, Nagaraj N, Mann M. Accurate proteome-wide label-free quantification by delayed normalization and maximal peptide ratio extraction, termed MaxLFQ. Molecular & Cellular Proteomics. 2014. https://www.sciencedirect.com/science/article/pii/S1535947620333107
- Navarro P, Kuharev J, Gillet LC, et al. A multicenter study benchmarks software tools for label-free proteome quantification. Nature Biotechnology. 2016. https://www.nature.com/articles/nbt.3685
- Li J, Van Vranken JG, Pontano Vaites L, et al. TMTpro reagents: a set of isobaric labeling mass tags enables simultaneous proteome-wide measurements across 16 samples. Nature Methods. 2020. https://www.nature.com/articles/s41592-020-0781-4
- Li J, et al. TMTpro-18plex: the expanded and complete set of TMTpro reagents for sample multiplexing. Journal of Proteome Research. 2021. https://pubs.acs.org/doi/10.1021/acs.jproteome.1c00168
- Ting L, Rad R, Gygi SP, Haas W. MS3 eliminates ratio distortion in isobaric multiplexed quantitative proteomics. Nature Methods. 2011. https://www.nature.com/articles/nmeth.1714
- Messner CB, Demichev V, Bloomfield N, et al. Ultra-fast proteomics with Scanning SWATH. Nature Biotechnology. 2021. https://www.nature.com/articles/s41587-021-00860-4
- Guzmán UH, et al. Ultra-fast label-free quantification with narrow-window data-independent acquisition on an Orbitrap Astral mass spectrometer. Nature Biotechnology. 2024. https://www.nature.com/articles/s41587-023-02099-7
- Derks J, Leduc A, Wallmann G, et al. Increasing the throughput of sensitive proteomics by plexDIA. Nature Biotechnology. 2023. https://www.nature.com/articles/s41587-022-01389-w
- Xuan Y, et al. Standardization and harmonization of large-scale proteomics workflows for clinical samples. Nature Communications. 2020. https://www.nature.com/articles/s41467-020-18904-9