DDA 到 DIA:蛋白质组学为什么从“看见更多”走向“量得更稳”?
导读
在前两篇里,我们讲了蛋白质组学这十年的整体跃迁,也讲了质谱平台为什么突然变得又快、又深、又稳。
但只靠一台更强的质谱仪,还不够。质谱仪就像一台高速相机:它能拍得更快、更清楚,但真正决定你能否记录到关键瞬间的,还有一个问题:你到底怎么拍?
01|从“拍得更清楚”到“怎么拍”
质谱仪可以越来越快,但采集策略决定了数据的性格。
在蛋白质组学里,我们面对的不是一个整齐的分子清单,而是成千上万甚至更多的肽段信号。这些信号会在液相色谱中不断出现、消失、重叠。有的离子信号非常强,有的离子信号很弱;有些肽段对生物学问题至关重要,却不一定在采集瞬间最显眼。
这时,质谱仪必须回答一个问题:
当前这些离子,我应该先测谁?
这就是 DDA 和 DIA 的核心区别。
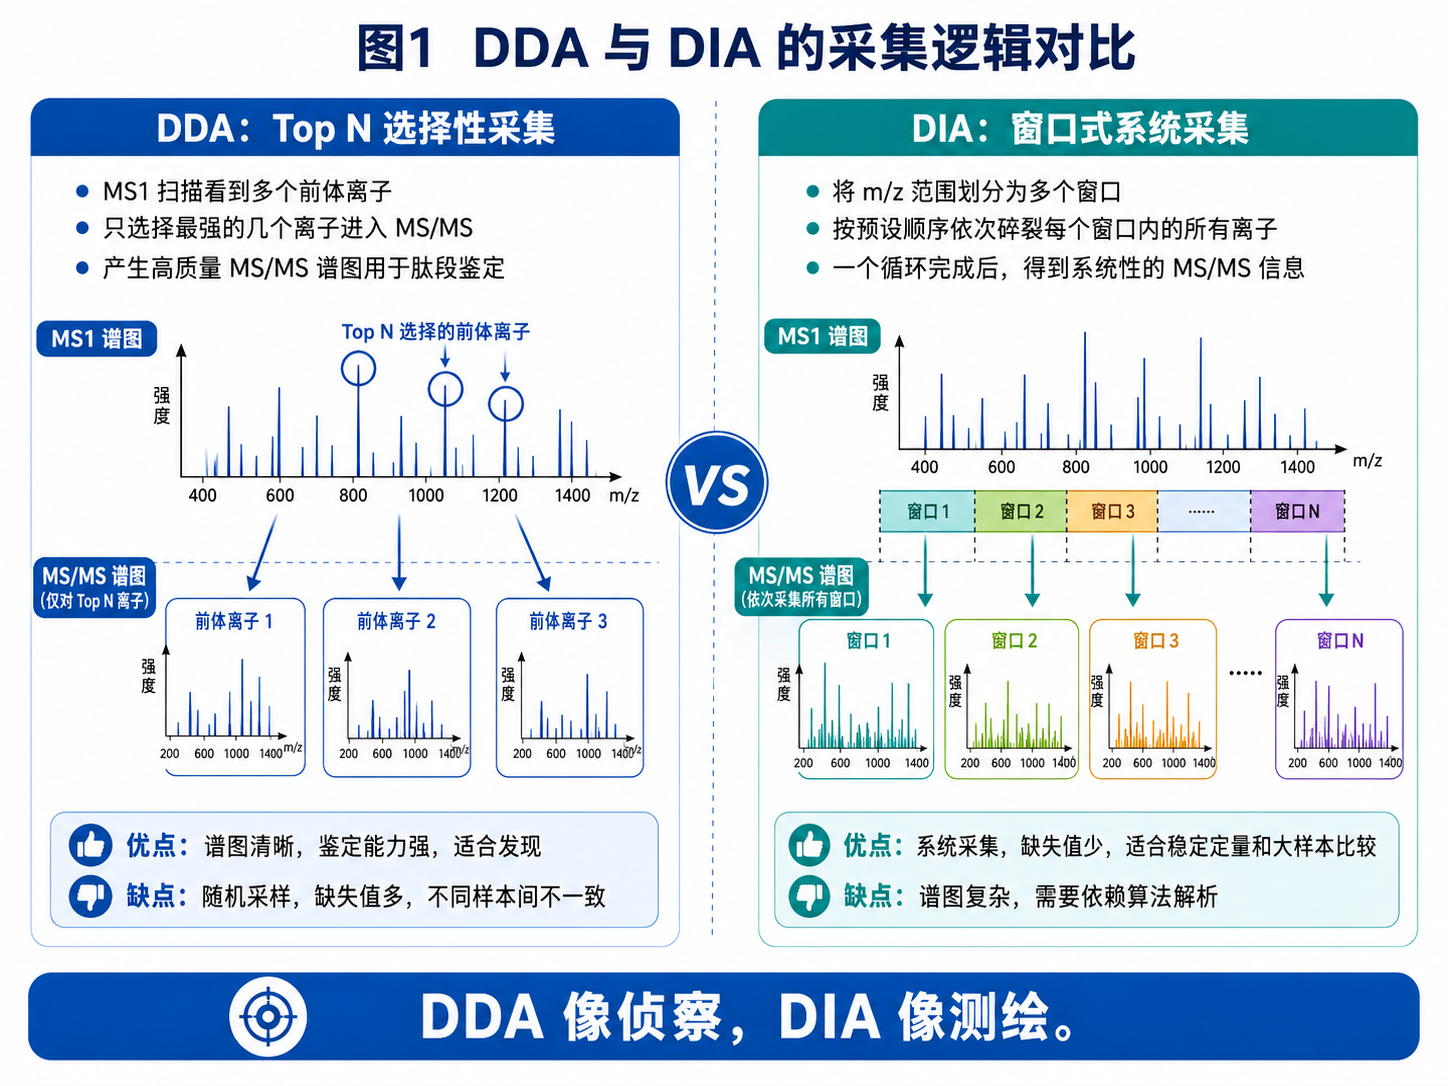
- DDA 像侦察兵,看到当前最强、最可疑的目标,就优先追踪。
- DIA 像测绘队,把预设区域系统性扫一遍,再从完整地图中提取目标。
过去很长一段时间,DDA 是发现型蛋白质组学的主力。它帮助研究者在复杂样本中鉴定出越来越多蛋白,把蛋白质组学带入大规模“看见蛋白”的时代。
但随着研究问题从少量样本扩展到临床队列、药物筛选、时间序列和多条件扰动实验,蛋白质组学开始需要另一种能力:
同一批蛋白,能不能在大量样本里稳定、完整、可重复地量出来?
于是,DIA 走到前台。
这一篇讲的,就是蛋白质组学采集策略的一次关键转向:从 DDA 到 DIA,为什么我们从“看见更多”,走向“量得更稳”。
02|先理解一个误区:质谱采集不是“自动看见一切”
很多人第一次接触蛋白质组学时,会以为质谱仪像显微镜一样:样本放进去,里面有什么就会被完整看见。
事实并不是这样。
在最常见的 bottom-up proteomics 中,蛋白质先被酶切成肽段,然后进入液相色谱,再进入质谱仪。问题在于,真实样本中的肽段数量极多,丰度差异巨大,而且会在色谱中短暂洗脱。
质谱仪必须在很短时间内决定:
- 先测哪些离子?
- 哪些离子拿去碎裂?
- 哪些信号可以用于定量?
- 哪些信息要留给后续算法解析?
所以,质谱采集策略不是小细节,而是决定数据性质的核心环节。
DDA 和 DIA 的差别,不是“旧技术”和“新技术”的简单替换,而是两种不同的数据采集哲学。
| 采集策略 | 类比 | 核心逻辑 | 数据特征 |
|---|---|---|---|
| DDA | 侦察 | 当前最强信号优先进入 MS/MS | 谱图较清晰,适合发现,但跨样本一致性较弱 |
| DIA | 测绘 | 预设 m/z 窗口系统性采集 | 数据更完整,适合稳定定量,但解析更复杂 |
03|DDA:发现型蛋白质组学的经典主力
DDA,全称 data-dependent acquisition,中文常译为数据依赖采集。
它的工作逻辑可以简化成三步:
- 质谱仪先做一次 MS1 扫描,观察当前进入仪器的前体离子。
- 从这些离子里挑选信号较强的一批,例如 Top 10、Top 20 或 Top N。
- 把这些被选中的离子逐个碎裂,产生 MS/MS 谱图,用于肽段和蛋白鉴定。
DDA 的优点非常明显:它很适合发现。
因为它优先碎裂强信号离子,所以 MS/MS 谱图质量通常较好,肽段鉴定相对直接,数据库搜索体系成熟。大量经典的 shotgun proteomics 研究,就是建立在 DDA 之上。
但 DDA 也有一个天然问题:
它是“当场选择”的。
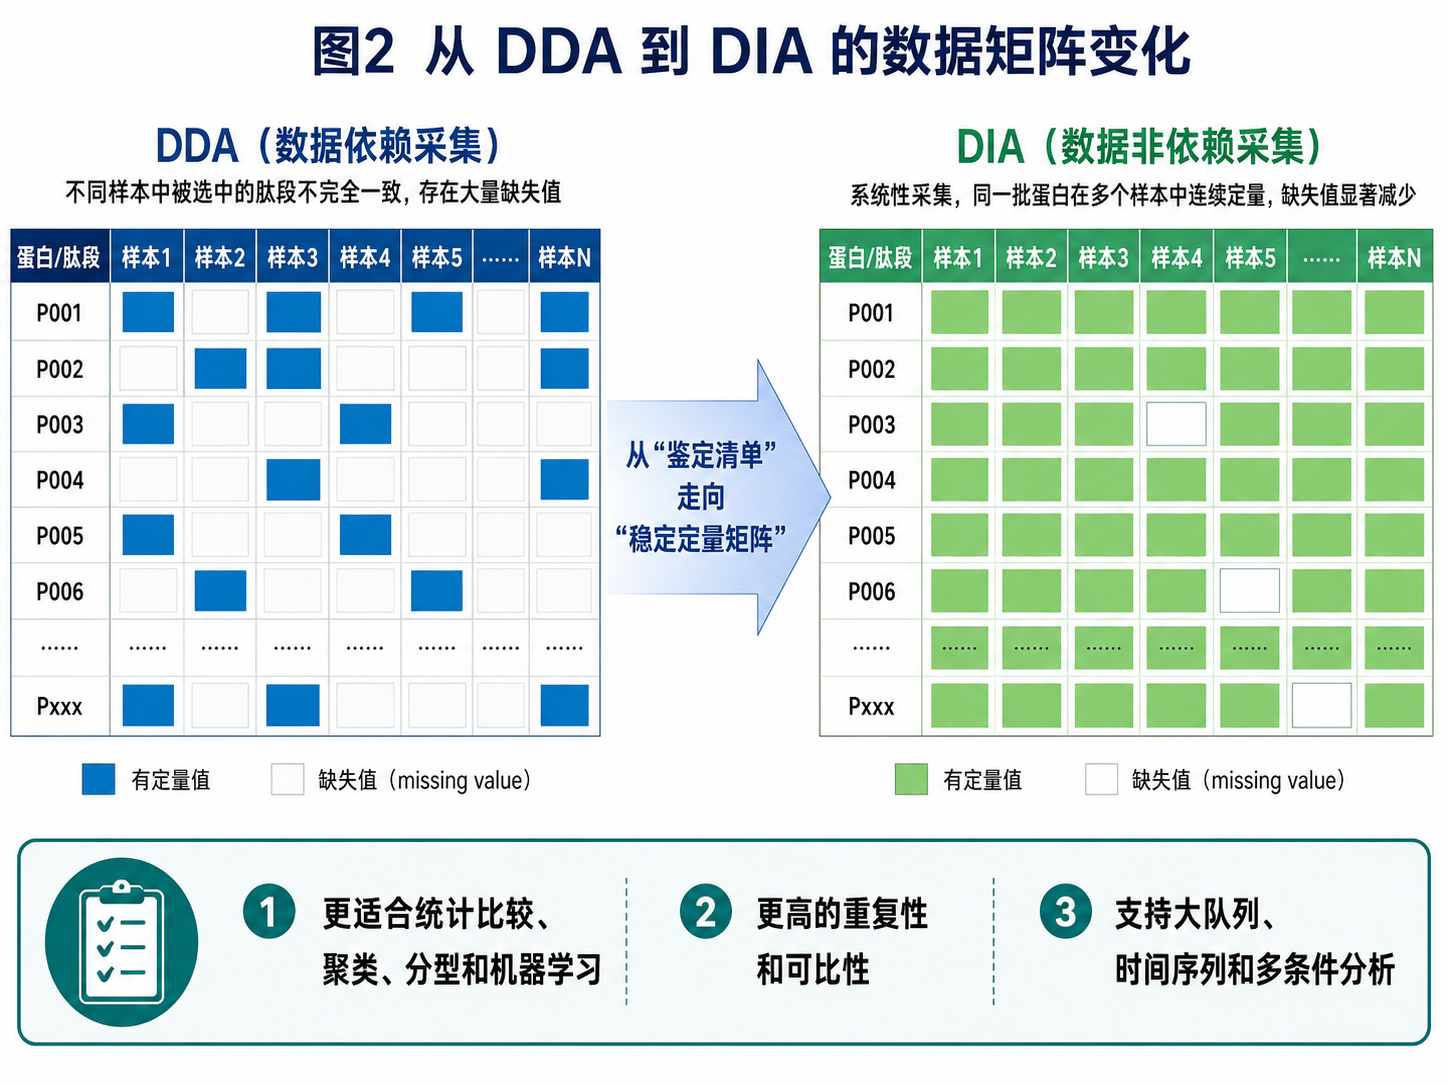
如果某个肽段在一个样本中刚好信号强,它可能被选中;在另一个样本中由于共洗脱、离子抑制或信号略弱,它就可能没被选中。这样一来,不同样本之间被鉴定到的肽段集合就不完全一致。
这就是 DDA 中常见的 missing value 问题。
对少量样本的发现型实验来说,这个问题可以接受;但对大队列、临床样本和时间序列来说,它会严重影响统计分析。因为你不仅想知道“有没有测到某个蛋白”,还想知道“这个蛋白在所有样本中到底变了多少”。
Nature Protocols 2015 年关于 DIA 与 Skyline 的文章也明确指出,DIA 的系统性采集方式不同于 DDA;在 DDA 中,MS/MS 谱图只适合鉴定一个被随机性采样到的肽段集合。[1]
所以,DDA 的核心矛盾可以概括为:
强在发现,弱在跨样本稳定性。
04|DIA:不再只追最亮的信号,而是系统性采集
DIA,全称 data-independent acquisition,中文常译为数据非依赖采集。
它的思路和 DDA 完全不同。
DIA 不再根据 MS1 中谁最强来决定碎裂谁,而是把一段 m/z 范围切成一个个窗口。质谱仪按照预设顺序依次采集这些窗口,并把窗口内的离子一起碎裂。
比如,一个实验可以把 400–1000 m/z 切成多个窗口。质谱仪不会问“现在最强的离子是谁”,而是按窗口依次扫过去:
- 这个窗口碎裂一次;
- 下一个窗口碎裂一次;
- 再下一个窗口碎裂一次;
- 一个循环完成后,预设质量范围内的离子都获得了系统性 MS/MS 信息。
这种思想并不是突然出现的。早在 2004 年,Venable、Yates 等就提出了不依赖数据的顺序窗口碎裂策略,用于复杂肽段混合物的定量分析。[2]
但 DIA 真正成为现代蛋白质组学的核心路线,离不开 2012 年 Gillet、Aebersold 等提出的 SWATH-MS 思想:利用数据非依赖采集产生完整的碎片离子图谱,再通过靶向数据提取实现一致、准确的蛋白质组分析。[3]
SWATH-MS 的关键,不是“把所有东西都粗暴碎裂一遍”,而是把样本变成一种可重复查询的数字图谱。
换句话说:
DDA 更像是在实验当下做选择;DIA 更像是先保存一张系统性地图,再用算法回头查找你关心的肽段。
这也是 DIA 后来常被理解为“digital proteome map”的原因之一。
05|为什么 DIA 更适合稳定定量?
DIA 之所以适合稳定定量,核心原因有三个。
1. 采集更系统
DDA 会根据当时的信号强弱选择离子,所以不同样本中被选中的离子可能不同。DIA 则按照预设窗口采集,不依赖某个肽段在那一刻是否进入 Top N,因此更容易在多个样本中获得一致的数据矩阵。
2. 缺失值更少
在大队列研究中,缺失值会影响统计功效,也会影响后续的聚类、分型、机器学习和通路分析。
2024 年 Molecular & Cellular Proteomics 的 DIA 临床蛋白质组学综述指出,DIA 系统性采样给定 m/z 范围内的肽段,能够缓解 missing value 问题,并提高定量准确性、精密度和可重复性。[4]
3. 更适合批量比较
当你要比较几十、几百甚至上千个样本时,最怕的不是每个样本少测几个蛋白,而是不同样本之间测到的蛋白集合不一致。
DIA 的价值在于,它更容易形成一个共同的“特征矩阵”,让统计分析站得住。
2017 年一项跨 11 个实验室的 SWATH-MS 多中心评估显示,该方法可以用于大规模定量蛋白质组学的跨实验室重复性评估;研究中各实验室使用相同仪器和采集参数分析标准样本,并报告了较好的定量重复性,例如多数实验室的日内和日间 CV 低于 20%。[5]
所以,DIA 的本质优势不是“每次一定比 DDA 鉴定更多蛋白”,而是:
当样本数变大时,它更容易保持一致。
06|从“鉴定清单”到“稳定定量矩阵”
DDA 时代,研究者常常会问:
这次实验我鉴定到了多少蛋白?
这个问题当然重要。但当样本量变大时,另一个问题变得更关键:
这些蛋白能不能在所有样本中稳定量到?
这就是“鉴定清单”和“定量矩阵”的区别。
如果一个蛋白只在部分样本中被鉴定到,那么你很难判断它是真正缺失、表达很低,还是没有被采集到。缺失值越多,后续统计就越不稳。
而 DIA 的优势,是更容易形成跨样本连续定量矩阵。这对下面这些分析尤其重要:
- 疾病组和对照组比较;
- 药物处理前后比较;
- 时间序列分析;
- 患者分型和聚类;
- 多组学整合;
- 机器学习预测模型。
因此,DIA 的普及不是单纯换了一种采集方式,而是把蛋白质组学从“单个样本的覆盖深度”,推向“整个研究设计的数据质量”。
07|DIA 的难题:数据更完整,也更复杂
当然,DIA 不是免费的午餐。
DDA 的谱图相对干净,因为一个 MS/MS 谱图通常主要来自某个被选中的母离子。DIA 的谱图则更复杂,因为一个窗口内可能有多个肽段同时被碎裂。于是,碎片离子会混在一起,形成高度 multiplexed 的 MS/MS 谱图。
这带来一个核心问题:
你怎么知道某个碎片离子到底来自哪个肽段?
DIA 的难点,恰恰在这里。
早期 DIA 的发展很大程度上依赖谱图库。研究者先用 DDA 或其他方式建立一个 spectral library,里面记录某些肽段的保留时间、碎片离子 m/z、碎片强度等信息。然后在 DIA 数据中,软件按照这个库去提取对应信号。
这个过程有点像在复杂录音里识别某个人的声音:你事先知道这个人的声纹,再去混合音频里找它。
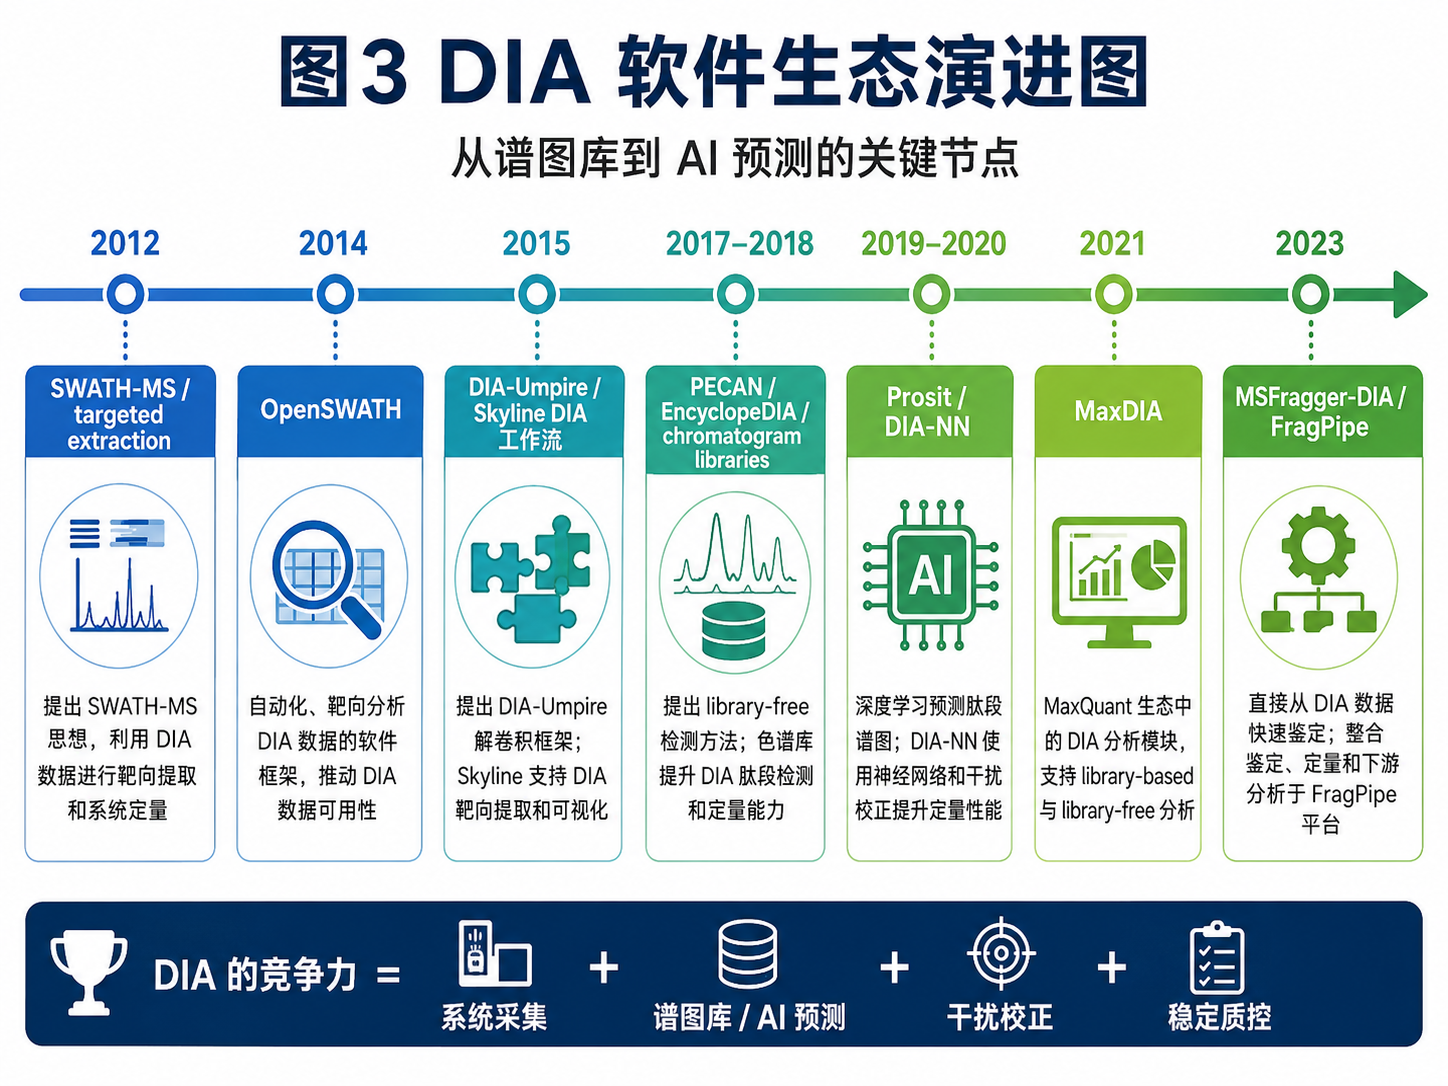
OpenSWATH 是早期重要软件之一。2014 年发表在 Nature Biotechnology 的 OpenSWATH 论文介绍了一个自动化、靶向分析 DIA 数据的软件框架,使得 DIA/SWATH 数据可以进行系统性目标提取。[6]
随后,DIA-Umpire、Skyline、EncyclopeDIA、Spectronaut、DIA-NN、MaxDIA、MSFragger-DIA 等软件和工作流不断发展,让 DIA 从“可行”走向“普及”。
DIA-Umpire 在 2015 年提出了一个综合计算框架,用于 DIA 蛋白质组学分析,尝试从复杂 DIA 数据中解卷积和生成可用于搜索的伪 MS/MS 信息。[7]
EncyclopeDIA 相关研究则显示,chromatogram libraries 可以改善 DIA 中肽段检测和定量。[8]
也就是说,DIA 的核心技术瓶颈从来不只是质谱硬件,而是:
硬件采集和计算解析共同构成的系统能力。
08|从谱图库到 AI:DIA 真正进入软件时代
过去几年,DIA 发展的一个重要趋势是:它越来越依赖高质量计算。
早期 DIA 很依赖实验谱图库。谱图库越接近样本真实情况,提取效果往往越好。但实验谱图库也有局限:构建麻烦,可能引入偏倚,也未必覆盖样本中的全部肽段。
于是,library-free 和 predicted library 逐渐成为重要方向。
2017 年,PECAN 提出 library-free peptide detection,用于在不依赖实验谱图库的情况下分析 DIA 数据。[9]
2019 年,Prosit 展示了深度学习预测肽段 MS/MS 谱图的能力,为构建 in silico 谱图库提供了重要基础。[10]
DIA-NN 则是 DIA 软件普及中的一个代表。它使用神经网络、干扰校正和新的定量策略来处理 DIA 数据,尤其适合高通量和短梯度场景。DIA-NN 论文指出,该工具可以提升常规 DIA 应用中的鉴定和定量表现,并在快速色谱条件下实现深度且可信的蛋白质组覆盖。[11]
MaxDIA 在 2021 年进入 MaxQuant 生态,支持 library-based 和 library-free 的 DIA 分析,并强调以可靠 FDR 控制为基础的 discovery DIA。[12]
2023 年,MSFragger-DIA / FragPipe 提出直接从 DIA 数据进行快速肽段鉴定的方案,并把 DIA 鉴定、谱图库构建和定量流程整合到 FragPipe 平台中。该研究还在单细胞蛋白质组、磷酸化蛋白质组和大规模肿瘤蛋白质组等不同数据类型中展示了应用。[13]
这些进展说明,DIA 的成功不只是“采集窗口设计得好”,而是进入了一个新阶段:
质谱仪负责系统性记录,算法负责从复杂记录里恢复生物学信号。
这也是为什么现在讲 DIA,必须同时讲软件。
09|DIA 也在进化:窗口越来越聪明,维度越来越多
DIA 的基本思想是系统性窗口采集,但具体怎么切窗口、怎么安排循环、怎么利用离子淌度,过去十年一直在进化。
最朴素的 DIA 可以使用固定宽度窗口。比如每个窗口 20 m/z 或 25 m/z,依次覆盖一段质量范围。
但固定窗口有问题:不同 m/z 区间的肽段密度不一样。有些区域离子很多,窗口太宽会导致谱图过于复杂;有些区域离子较少,窗口太窄又浪费扫描时间。
于是出现了 variable-window DIA,根据不同质量区间的离子密度调整窗口宽度。
再后来,研究者开始使用 narrow-window DIA、gas-phase fractionation DIA、FAIMS-DIA、diaPASEF 等策略,让 DIA 既能保持系统性,又能降低混合谱图复杂度。
diaPASEF 是一个关键例子。2020 年 Nature Methods 论文将 PASEF 与 DIA 结合,在 trapped ion mobility 维度中设计采集窗口,利用 m/z 和离子淌度两个维度提高前体离子采样效率。[14]
这说明,DIA 的发展不是单一方向,而是在不断追求一个平衡:
窗口要足够宽,才能提高通量;
窗口又要足够窄,才能降低干扰;
循环要足够快,才能捕捉色谱峰;
数据又要足够清楚,才能稳定定量。
DIA 的进化,本质上是在这个多目标优化问题中不断前进。
10|DDA、DIA、PRM/SRM:不是谁取代谁,而是各有位置
写到这里,很容易给人一种感觉:DIA 比 DDA 更先进,所以 DDA 要被淘汰。
这个说法不准确。
DDA 仍然非常重要,尤其适合发现型研究、谱图库构建、新修饰探索、样本复杂性摸底和需要高质量单肽段 MS/MS 谱图的场景。很多 DIA 工作流仍然会使用 DDA 数据来建立或增强谱图库。
DIA 更适合稳定定量,尤其适合大样本量、多条件比较、临床队列、药物扰动筛选和需要减少 missing value 的实验。
PRM/SRM 则适合目标明确的验证型实验。SRM/MRM 在三重四极杆平台上长期用于可靠定量。2008 年 SRM 教程强调,其作为靶向定量策略,在复杂混合物中可靠定量低丰度 analytes 方面具有独特优势。[15] PRM 则借助高分辨率质谱进行靶向定量,2012 年相关工作指出 PRM 在性能上可与 SRM 相比,同时减少靶向 assay 开发负担。[16]
因此,更合理的技术地图是:
| 方法 | 更像什么 | 主要优势 | 主要短板 | 适合场景 |
|---|---|---|---|---|
| DDA | 发现型侦察 | 谱图清晰,鉴定体系成熟,适合探索 | 随机采样,缺失值较多 | 发现新蛋白、新肽段、新修饰,建库 |
| DIA | 系统性测绘 | 重复性好,缺失值少,适合大样本定量 | 混合谱图复杂,依赖算法 | 大队列、时间序列、药物筛选、临床研究 |
| PRM / SRM | 靶向验证 | 灵敏、准确、可验证关键蛋白 | 通量相对有限,需要目标预设 | biomarker 验证、候选通路验证、临床 assay 开发 |
这三类方法不是简单竞争关系,而是构成一个完整链条:
DDA 用来发现,DIA 用来规模化定量,PRM/SRM 用来验证。
11|DIA 改变的不只是技术,而是实验设计方式
DIA 的普及,真正改变的是蛋白质组学实验设计。
在 DDA 时代,研究者常常会问:
- 这个样本我能鉴定多少蛋白?
- 这次实验能不能多测一点?
- 能不能通过更长梯度、更充分分级提高覆盖度?
在 DIA 时代,研究者开始问:
- 这些蛋白能不能在所有样本中稳定量到?
- 缺失值是否足够少?
- 数据矩阵是否适合统计建模?
- 这个方法能不能支撑上百、上千个样本?
- 后续还能不能回头挖掘新的目标?
DIA 把蛋白质组学从“单个样本的深度表现”,推向“整个研究设计的数据质量”。
这对临床队列尤其关键。临床样本的异质性远高于细胞系,批次、个体差异、样本质量和前处理差异都会影响结果。
2022 年一项使用真实患者异质性数据的大规模 DIA 工作流 benchmark 显示,DIA 数据分析需要综合考虑谱图库、软件、稀疏性处理、归一化和统计检验等多个环节,而不同工作流会显著影响差异蛋白识别表现。[17]
换句话说,DIA 让“采集更稳”成为可能,但真正要得到可靠生物学结论,还需要从样本设计、质控、软件、统计和验证全链条把关。
这也是现代蛋白质组学越来越像一门系统工程的原因。
12|DIA 的局限:稳定不等于简单
DIA 很强,但并不意味着它没有问题。
1. 谱图干扰
DIA 的窗口内同时碎裂多个前体离子,混合谱图中可能存在干扰信号。窗口越宽、样本越复杂,这个问题越明显。
2. 软件差异
不同软件、不同谱图库、不同 FDR 控制、不同 normalization 方法,可能带来不同结果。2023 年 Nature Communications 的 DIA 和磷酸化蛋白质组 benchmarking 研究比较了 DIA-NN、Spectronaut、MaxDIA 和 Skyline 等软件与不同谱图库组合,显示软件和谱图库选择会影响 DIA 数据处理结果。[18]
3. 修饰和变体更难
常规蛋白表达量分析已经相对成熟,但磷酸化、泛素化、糖基化、变体肽段、免疫肽组等任务,仍然需要更精细的采集策略、谱图库和评分体系。
4. 不能只追求蛋白数量
DIA 很容易被用来展示“我们量到了多少蛋白”,但真正重要的是定量是否准确、批次是否稳定、统计是否合理、生物学解释是否可信。
所以,DIA 不是让蛋白质组学变简单,而是把难点从“能不能测到”转移到了“能不能正确解释复杂数据”。
13|这一篇的核心结论
如果用一句话总结 DDA 到 DIA 的跃迁,我会这样说:
DDA 帮助蛋白质组学看见了更多蛋白,DIA 则让蛋白质组学更稳定地比较更多样本。
DDA 的价值,在于探索。
DIA 的价值,在于可重复定量。
AI 和谱图预测的价值,在于把 DIA 复杂数据解析成可用的生物学信号。
PRM/SRM 的价值,在于把候选发现推进到靶向验证。
这就是蛋白质组学从“测到蛋白”走向“读懂生命状态”的关键一步。
因为生命状态不是一个样本里的单次发现,而是大量样本、多个时间点、不同条件、不同个体之间的稳定比较。
当蛋白质组学可以在这些复杂场景中形成可靠的数据矩阵,它才真正开始具备解释疾病、药物、通路和细胞状态的能力。
下一篇,我们继续往前走:
一次测几十、几百、几千个样本:蛋白质组学如何进入高通量定量时代。
参考文献线索
- Egertson JD, MacLean B, Johnson R, Xuan Y, MacCoss MJ. Multiplexed peptide analysis using data-independent acquisition and Skyline. Nature Protocols. 2015. https://www.nature.com/articles/nprot.2015.055
- Venable JD, Dong MQ, Wohlschlegel J, Dillin A, Yates JR. Automated approach for quantitative analysis of complex peptide mixtures from tandem mass spectra. Nature Methods. 2004. https://www.nature.com/articles/nmeth705
- Gillet LC, Navarro P, Tate S, et al. Targeted data extraction of the MS/MS spectra generated by data-independent acquisition: a new concept for consistent and accurate proteome analysis. Molecular & Cellular Proteomics. 2012. https://www.sciencedirect.com/science/article/pii/S1535947620304424
- Fröhlich K, et al. Milestones and perspectives of data-independent acquisition in clinical proteomics. Molecular & Cellular Proteomics. 2024. https://www.sciencedirect.com/science/article/pii/S1535947624000902
- Collins BC, Hunter CL, Liu Y, et al. Multi-laboratory assessment of reproducibility, qualitative and quantitative performance of SWATH-mass spectrometry. Nature Communications. 2017. https://www.nature.com/articles/s41467-017-00249-5
- Röst HL, Rosenberger G, Navarro P, et al. OpenSWATH enables automated, targeted analysis of data-independent acquisition MS data. Nature Biotechnology. 2014. https://www.nature.com/articles/nbt.2841
- Tsou CC, Avtonomov D, Larsen B, et al. DIA-Umpire: comprehensive computational framework for data-independent acquisition proteomics. Nature Methods. 2015. https://www.nature.com/articles/nmeth.3255
- Searle BC, Pino LK, Egertson JD, et al. Chromatogram libraries improve peptide detection and quantification by data-independent acquisition mass spectrometry. Nature Communications. 2018. https://www.nature.com/articles/s41467-018-07454-w
- Ting YS, Egertson JD, Bollinger JG, et al. PECAN: library-free peptide detection for data-independent acquisition tandem mass spectrometry data. Nature Methods. 2017. https://www.nature.com/articles/nmeth.4390
- Gessulat S, Schmidt T, Zolg DP, et al. Prosit: proteome-wide prediction of peptide tandem mass spectra by deep learning. Nature Methods. 2019. https://www.nature.com/articles/s41592-019-0426-7
- Demichev V, Messner CB, Vernardis SI, Lilley KS, Ralser M. DIA-NN: neural networks and interference correction enable deep proteome coverage in high throughput. Nature Methods. 2020. https://www.nature.com/articles/s41592-019-0638-x
- Sinitcyn P, Hamzeiy H, Salinas Soto F, et al. MaxDIA enables library-based and library-free data-independent acquisition proteomics. Nature Biotechnology. 2021. https://www.nature.com/articles/s41587-021-00968-7
- Yu F, Haynes SE, Nesvizhskii AI. IonQuant enables accurate and sensitive label-free quantification with FDR-controlled match-between-runs. / MSFragger-DIA / FragPipe DIA workflow. Nature Communications. 2023. https://www.nature.com/articles/s41467-023-39869-5
- Meier F, Brunner AD, Frank M, et al. diaPASEF: parallel accumulation–serial fragmentation combined with data-independent acquisition. Nature Methods. 2020. https://www.nature.com/articles/s41592-020-00998-0
- Picotti P, Aebersold R. Selected reaction monitoring–based proteomics: workflows, potential, pitfalls and future directions. Molecular Systems Biology. 2012. https://www.embopress.org/doi/full/10.1038/msb.2012.58
- Peterson AC, Russell JD, Bailey DJ, Westphall MS, Coon JJ. Parallel reaction monitoring for high resolution and high mass accuracy quantitative, targeted proteomics. Molecular & Cellular Proteomics. 2012. https://www.nature.com/articles/nmeth.2193
- Lou R, et al. Benchmarking commonly used software suites and analysis workflows for DIA proteomics and phosphoproteomics. Nature Communications. 2022. https://www.nature.com/articles/s41467-022-30094-0
- Lou R, et al. Benchmarking and recommendations for DIA proteomics and phosphoproteomics analysis. Nature Communications. 2023. https://www.nature.com/articles/s41467-022-35740-1