从“测到蛋白”到“读懂生命状态”:蛋白质组学十年技术跃迁
导读
如果说基因组给了我们一份生命的“说明书”,那么蛋白质组学更像是在追踪这份说明书此刻如何被执行。过去十年,蛋白质组学的核心问题,正在从“测到了多少蛋白”,转向“这些蛋白共同揭示了什么生命状态”。
01|为什么要从“测到蛋白”讲起?
基因可以告诉我们一个细胞“可能”具备什么能力,RNA 可以告诉我们哪些指令正在被转录,而蛋白质则更接近生命活动的现场:
- 酶是否被激活;
- 通路是否被点燃;
- 药物是否真正击中了靶点;
- 免疫细胞是否进入了某种状态;
- 肿瘤组织里不同区域是否在进行完全不同的生存策略。
这也是为什么,过去十年,蛋白质组学的关键词正在发生变化。
早期我们常问的是:测到了多少蛋白?
现在我们更关心的是:这些蛋白共同揭示了什么生命状态?
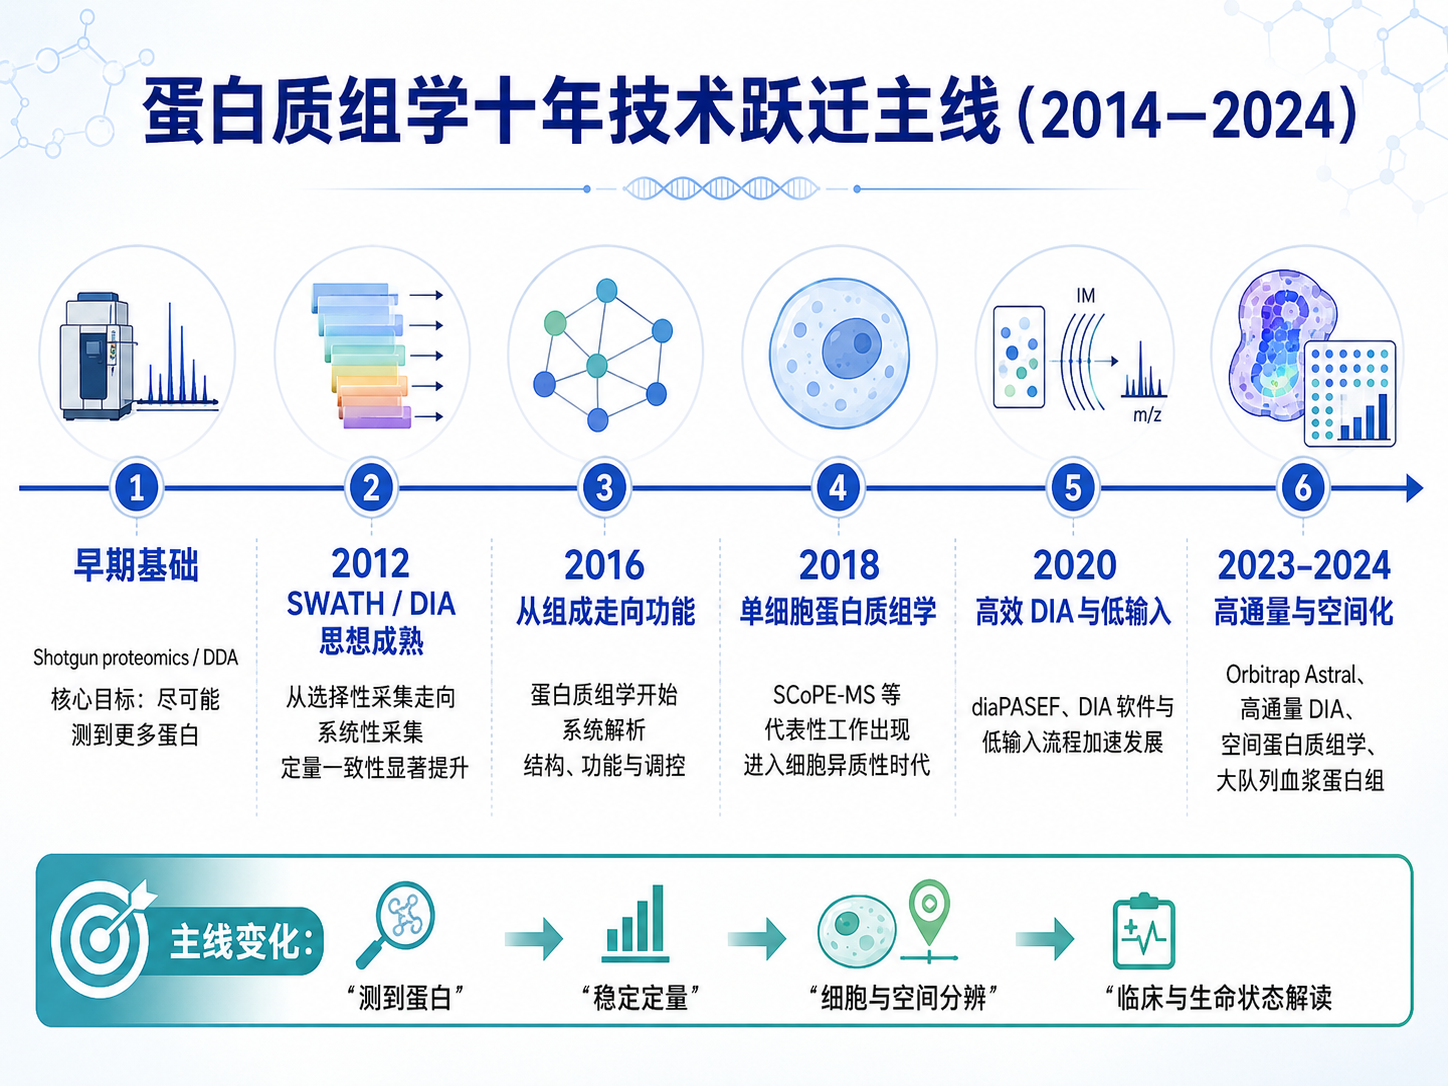
这个转变,不只是“仪器更快了”“数据库更大了”这么简单。它背后是质谱硬件、数据采集策略、样本制备、计算方法、空间解析、单细胞技术和临床大队列共同推动的一次系统性跃迁。
02|蛋白质组学最初的难题:测到蛋白,已经很不容易
蛋白质组学天生比基因组学更难。
DNA 的信息相对稳定,四种碱基构成了可被放大的序列;但蛋白质不一样。它们丰度跨度极大,结构复杂,会被磷酸化、乙酰化、泛素化、糖基化等修饰,还会在不同细胞器、不同组织区域、不同疾病状态中发生动态变化。
更关键的是,蛋白质不能像 DNA 那样简单扩增。一个样本里低丰度蛋白的信号,可能被高丰度蛋白淹没;一个真正重要的信号,也可能因为样本制备、色谱分离、质谱采集或算法分析的差异而消失。
因此,在很长一段时间里,蛋白质组学的主要成就首先是看见:从复杂样本中鉴定出越来越多的蛋白,把过去只能研究单个蛋白的生物化学,推进到同时观察成千上万个蛋白的系统层面。
这一步本身就是巨大的技术突破。早在 2003 年,Aebersold 和 Mann 就在 Nature 综述中指出,质谱蛋白质组学已经能够识别并逐步精确定量复杂样本中的数千种蛋白,并将在生物学和医学中产生广泛影响。[1]
但“测到”并不等于“读懂”。
一个蛋白被鉴定出来,只说明它在样本中留下了可被检测的证据。真正的问题是:
- 它的丰度有没有变化?
- 变化是否可靠?
- 它是否带有关键修饰?
- 它处在什么细胞类型、什么空间位置、什么通路网络中?
- 它与疾病、药物、表型之间有什么关系?
过去十年的蛋白质组学,正是在回答这些问题。
03|先向经典致敬:今天的跃迁不是凭空发生的
谈最近十年的蛋白质组学,不能只谈“新”。很多今天看似自然发生的进步,其实都有清晰的技术源头。
经典一:大规模质谱蛋白质组学
它让我们第一次可以在复杂生物样本中系统性观察蛋白,而不是只盯着少数几个候选分子。
经典二:计算蛋白质组学的成熟
2008 年发表的 MaxQuant 是一个标志性工具。它面向高分辨率定量质谱数据,能够自动完成大规模肽段识别和蛋白定量,在当时已经可以对哺乳动物细胞裂解液中的 4000 多个蛋白进行稳健鉴定和定量。[2]
经典三:数据采集策略的重构
2012 年,Gillet、Aebersold 等提出基于数据非依赖采集的 SWATH-MS 思路,用连续窗口系统性采集碎片离子图谱,再通过靶向数据提取获得一致、准确的蛋白质组定量信息。这个思想后来成为 DIA 技术路线的重要基础。[3]
经典四:蛋白质组学目标本身的升级
2016 年,Aebersold 和 Mann 在 Nature 综述中把质谱蛋白质组学的能力概括为探索蛋白质组的组成、结构、功能和调控,而不仅仅是做一个蛋白清单。[4]
所以,过去十年的变化不是从零开始。
它是在这些经典工作之上继续往前走:从“鉴定更多蛋白”,走向“稳定定量蛋白”;从“平均样本里的蛋白清单”,走向“细胞状态、空间位置、疾病过程和药物响应的系统读数”。
04|第一场跃迁:从 DDA 到 DIA,蛋白质组学开始变得更可重复
过去很长一段时间,发现型蛋白质组学主要依赖 DDA,也就是数据依赖采集。
简单说,DDA 像是在复杂样本中“挑最显眼的信号来测”。这种方式非常适合发现和鉴定,但也带来一个问题:不同样本、不同批次中被选中的离子可能不完全一样,于是就容易产生 missing value,也就是有些蛋白在这个样本中被测到,在另一个样本中却没有被稳定记录。
当研究对象从几个样本扩大到几十、几百甚至上千个样本时,这个问题会被放大。临床队列、药物筛选、时间序列、多条件扰动实验,都需要更完整、更可重复的数据矩阵。
DIA 的出现,改变了这个局面。
DIA 不再只挑选当下最强的若干信号,而是按照预设窗口系统性采集一段质量范围内的离子信息。这样做的好处是,数据更加全面,样本之间更容易形成可比较的定量矩阵。2018 年的 SWATH-MS 教程文章也明确指出,DIA/SWATH-MS 的价值在于把深度蛋白质组覆盖能力与定量一致性、准确性结合起来,尤其适合个体化医学、药物筛选、系统生物学等需要大量样本的场景。[5]
当然,DIA 也带来了新的难题:数据更复杂了。一个窗口里可能混合了许多肽段的碎片离子,要从中解析出可靠的蛋白定量结果,非常依赖算法。
于是,蛋白质组学的竞争开始从“谁的仪器更强”,扩展到“谁能把复杂数据解释得更准”。DIA-NN 就是其中代表之一,它通过神经网络和干扰校正策略提升 DIA 数据的鉴定和定量表现,尤其适合高通量蛋白质组学场景。[6]
这场跃迁的意义在于:
蛋白质组学不再只是偶尔产生一张漂亮的蛋白列表,而是越来越能够产出可重复、可比较、可统计分析的大规模数据矩阵。
05|第二场跃迁:质谱仪从“更深”走向“又快又深”
如果把蛋白质组学比作一套观测系统,质谱仪就是核心发动机。
过去十年,质谱平台的进步主要体现在几个方向:
| 能力升级 | 对蛋白质组学意味着什么 |
|---|---|
| 更高灵敏度 | 更容易检测低丰度蛋白和小样本量样本 |
| 更快扫描速度 | 支撑短梯度、高通量和大队列研究 |
| 更高分辨率 | 提升复杂样本中的识别和定量质量 |
| 更好的离子利用率 | 减少信号浪费,提高可检测信息量 |
| 与离子淌度、自动化系统结合 | 增加分离维度,提升通量和稳定性 |
其中,PASEF 和 diaPASEF 是非常值得关注的技术路线。diaPASEF 把 trapped ion mobility、PASEF 和 DIA 结合起来,利用离子淌度维度提高采集效率和信号特异性。2020 年发表的 diaPASEF 研究显示,这种方式可以在 m/z 和淌度窗口中更高效地采样肽段前体离子电流,并在低样本量下实现较深覆盖和良好重复性。[7]
另一条重要路线是超高速质谱平台。Orbitrap Astral 相关研究展示了 narrow-window DIA 与高速 MS/MS 扫描结合后的潜力:在较短梯度下实现较深的人类蛋白质组覆盖,并显著提升每天可分析的样本数量。[8]
这类进展改变了蛋白质组学的使用边界。
过去,深度蛋白质组常常意味着长梯度、低通量、高成本;现在,越来越多研究开始追求“又快又深”:既要覆盖足够多蛋白,又要能承受大样本量。对于临床队列、药物扰动实验、细胞模型筛选来说,这一点尤其重要。
换句话说,蛋白质组学正在从“专家实验室里的高难度技术”,逐渐变成可以支撑规模化研究的分析平台。
06|第三场跃迁:样本从培养皿走向真实世界
技术成熟的标志之一,是它开始处理更真实、更复杂、更不完美的样本。
过去,蛋白质组学研究常常偏爱细胞系、大量组织、条件可控的实验体系。这样的样本适合技术开发,但真实生命状态往往存在于更复杂的场景里:患者血浆、手术组织、FFPE 样本、激光显微切割区域、稀有细胞群,甚至单个细胞。
低输入和单细胞蛋白质组学,正是在这个背景下兴起的。
2018 年发表的 SCoPE-MS 是单细胞质谱蛋白质组学的重要里程碑之一。该方法利用载体通道和多重标记策略,展示了在单个哺乳动物细胞中定量上千个蛋白,并用于分析细胞分化过程中的蛋白质组异质性。[9]
单细胞蛋白质组学目前仍然面临挑战,比如蛋白损失、覆盖深度、批次效应、数据缺失和定量精度。但它提出了一个非常重要的问题:
当我们说一个组织或一个肿瘤的蛋白质组发生变化时,这个变化到底来自所有细胞的平均变化,还是来自某一小群关键细胞的状态切换?
这个问题在肿瘤、免疫、神经、发育和药物耐受研究中都非常关键。
因此,低输入和单细胞蛋白质组学的意义,不只是“样本量更少也能测”,而是让蛋白质组学开始进入细胞异质性的层面。
07|第四场跃迁:从平均值走向空间位置
如果单细胞蛋白质组学解决的是“哪个细胞在变”,空间蛋白质组学追问的则是:
这些变化发生在哪里?
在组织里,细胞并不是孤立存在的。肿瘤细胞与免疫细胞的距离,血管周围的缺氧区域,炎症边界的信号分布,药物进入组织后的作用范围,都可能决定疾病的进展和治疗反应。
传统蛋白质组学常常需要把组织打碎,得到一个“平均蛋白质组”。这个平均值有时很有用,但也可能掩盖空间上的关键差异。
空间蛋白质组学正是为了解决这个问题。它包括多重免疫荧光、CODEX、MIBI、IMC 等成像型方法,也包括质谱成像、激光显微切割结合 LC-MS,以及 Deep Visual Proteomics 等保留空间上下文的质谱路线。
Nature Methods 将 spatial proteomics 评为 2024 年 Method of the Year,并指出空间蛋白质组学正在支撑组织图谱级项目,帮助理解健康和疾病中复杂组织的空间组织方式。[10]
这意味着蛋白质组学正在从“样本整体发生了什么”,走向“哪类细胞、哪个区域、哪种微环境发生了什么”。
对生命科学来说,这一步非常重要。因为很多疾病不是单个分子的异常,而是细胞状态、空间关系和组织结构共同改变的结果。
08|第五场跃迁:从科研技术走向临床大队列和药物发现
蛋白质组学的另一个明显趋势,是走向真实人群。
血浆蛋白质组尤其受到关注。血液样本相对易获得,其中包含大量与免疫、代谢、炎症、凝血、器官损伤和疾病风险相关的蛋白信号。过去,血浆蛋白质组受限于动态范围和通量,很难大规模应用;现在,基于亲和试剂的平台和质谱平台都在推动其进入大队列研究。
UK Biobank Pharma Proteomics Project 是一个代表性案例。该项目在数万名 UK Biobank 参与者中进行血浆蛋白质组分析,测量数千个蛋白分析物,并进行了大规模 pQTL 分析,用于连接遗传变异、蛋白水平和疾病相关表型。[11]
UK Biobank 项目页面也显示,该项目目标是对 56,000 份血浆样本进行多重蛋白质组 profiling,用于新药靶点识别、已有靶点和疗法验证,以及发现可用于患者分层或治疗反应预测的生物标志物。[12]
这类研究说明,蛋白质组学正在变成连接遗传、疾病、药物和临床表型的重要桥梁。
基因组告诉我们风险从哪里来,蛋白质组则可能告诉我们风险是否已经转化为可观察的生物状态。对于药物发现来说,这一点尤其关键:药物最终作用的是蛋白、通路和细胞状态,而不只是基因序列。
09|所以,什么叫“读懂生命状态”?
“读懂生命状态”不是一个抽象口号。
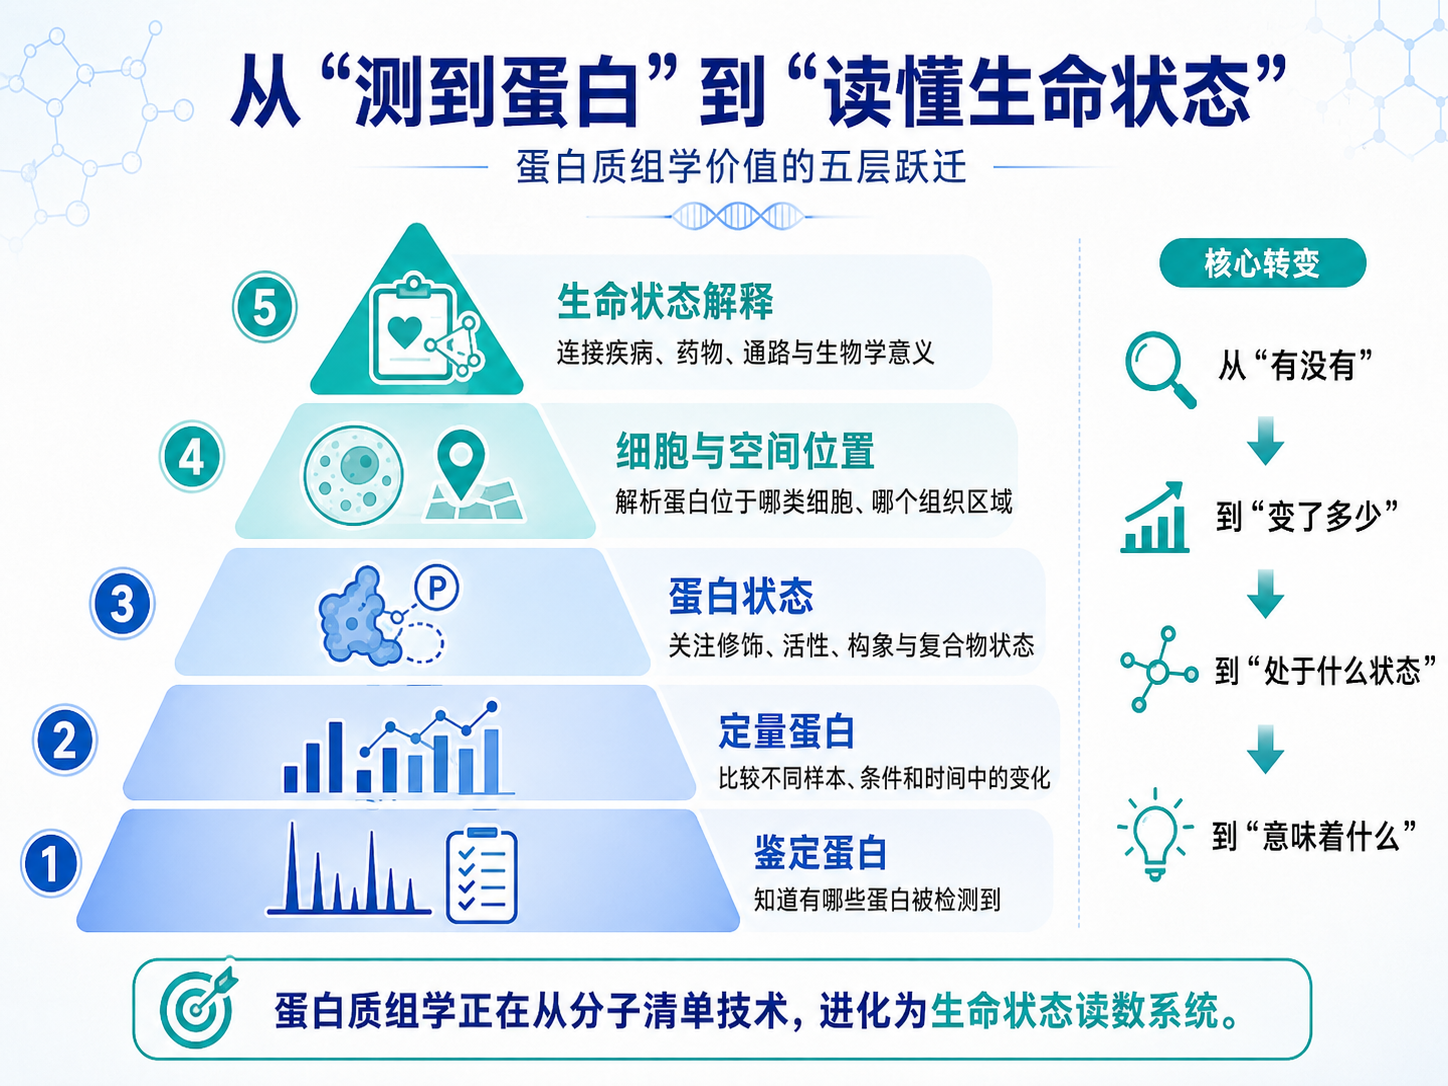
它至少包括五层含义。
| 层级 | 问题 | 解释 |
|---|---|---|
| 第一层 | 有哪些蛋白? | 这是蛋白质组学的基础,也是过去几十年不断推进的目标。 |
| 第二层 | 蛋白有多少? | 定量能力让我们可以比较疾病与健康、处理与对照、药物前后、时间序列中的变化。 |
| 第三层 | 蛋白处于什么状态? | 磷酸化、泛素化、糖基化、剪切、构象和复合物状态,往往决定一个蛋白是否真正发挥作用。 |
| 第四层 | 蛋白在哪里? | 同一个蛋白出现在不同细胞类型、细胞器或组织空间区域中,可能代表完全不同的生物学意义。 |
| 第五层 | 蛋白变化与表型有什么关系? | 这一步把蛋白质组学从技术平台推进到疾病机制、临床预测和药物发现。 |
过去十年的技术跃迁,正是沿着这五个层面展开的。
我们从“测到了多少蛋白”,走向“这些蛋白如何共同构成一个可解释的生命状态”。
10|结语:蛋白质组学正在成为生命科学的状态读数系统
今天再看蛋白质组学,它已经不只是基因组学之后的补充技术。
它正在成为一套生命状态读数系统。
在基础研究中,它帮助我们理解通路如何被调控、细胞如何分化、组织如何维持稳态。
在疾病研究中,它帮助我们寻找生物标志物、解析病理机制、识别患者分型。
在药物研发中,它帮助我们判断靶点是否被命中、通路是否被重塑、耐药是否正在发生。
在临床转化中,它有机会把一个人的分子状态,从静态风险推进到动态监测。
过去十年,蛋白质组学完成的不是一次单点技术升级,而是一场系统性跃迁:
仪器更快,采集更稳,算法更强,样本更小,空间更清楚,队列更大,问题也更接近真实生命。
这也解释了为什么我们要用一个系列来讨论它。
因为蛋白质组学的故事,已经不再只是“能测多少蛋白”的故事。它正在变成一个关于生命如何运行、疾病如何发生、药物如何奏效的故事。
系列地图:接下来我们会讲什么?
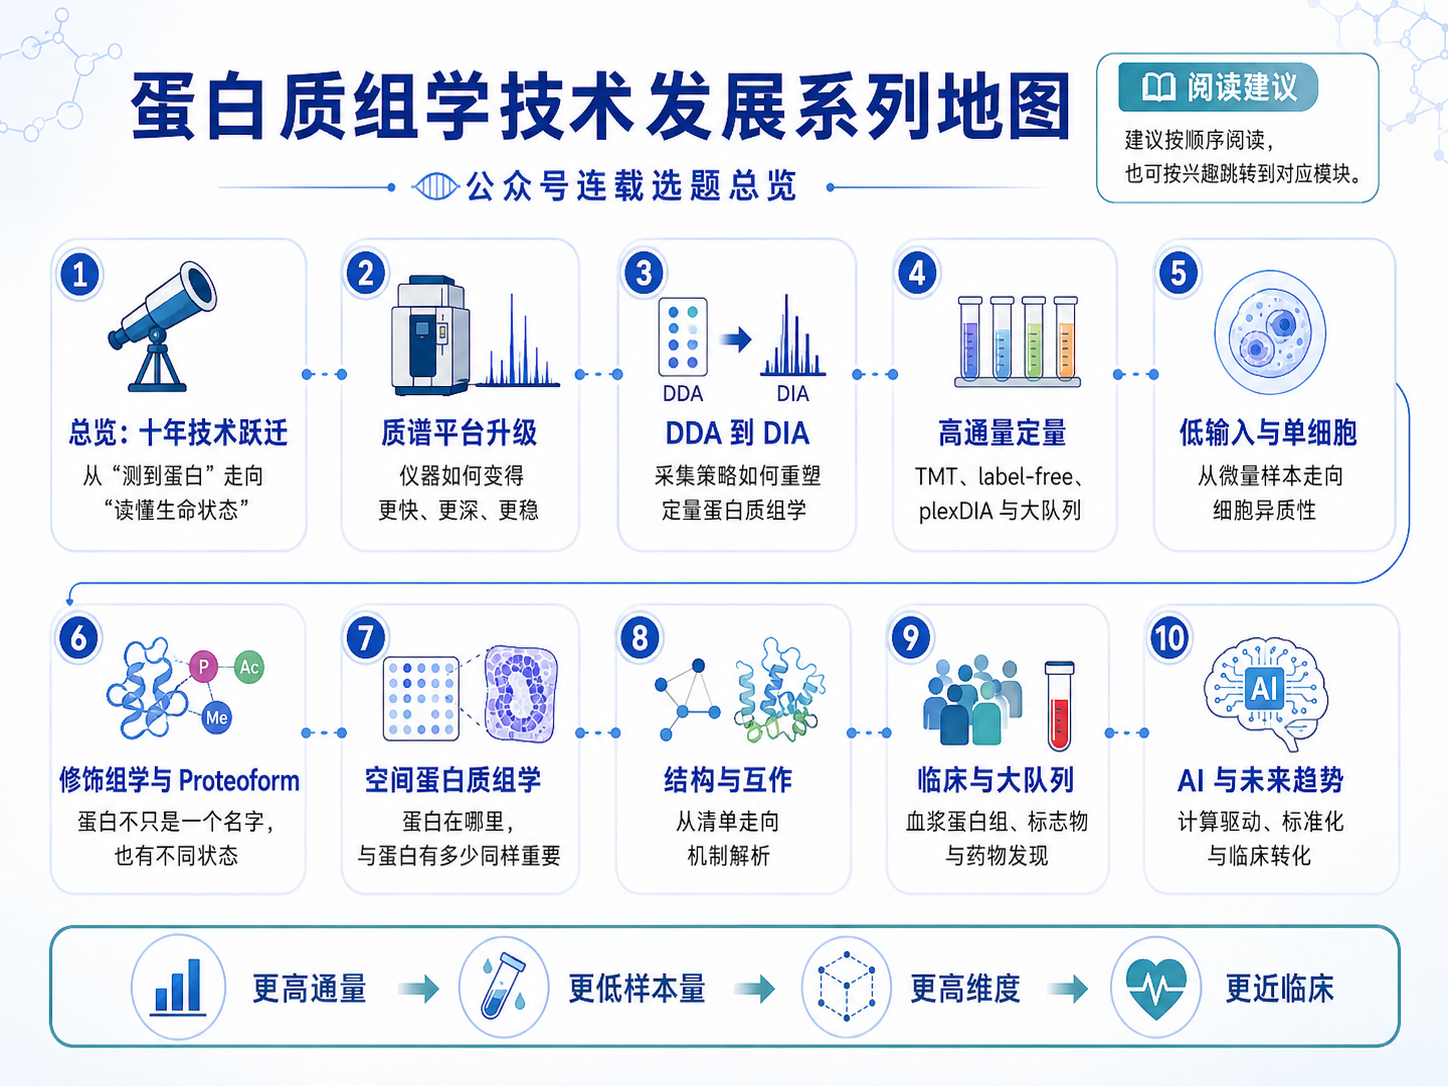
下一篇,我们从这套系统的“发动机”讲起:质谱平台这十年到底发生了什么,为什么它让蛋白质组学突然变得又快、又深、又可规模化。
参考文献
[1] Aebersold R, Mann M. Mass spectrometry-based proteomics. Nature. 2003.
[10] Method of the Year 2024: Spatial proteomics. Nature Methods.